
Anthropic lanzó Claude Opus 5.5 y me dejó con ganas de volver a poner Claude Code a trabajar en serio. Me tomé unas vacaciones de mis vacaciones en las Torres del Paine para abrir el anuncio, descomponerlo y probar el modelo. Valió la pena.
Hay bastante más que una nueva posición en una tabla. En el video reviso las mejoras en programación y trabajo profesional, los precios y qué significan realmente las cifras del lanzamiento. Al final también hay una prueba con el mismo prompt en Opus y GPT-6 Astra. El resultado de Opus me sorprendió muchísimo.
Esta guía reúne lo que más me importa del lanzamiento y lo que pude observar en esa primera prueba.
Qué trae Claude Opus 5.5
Opus 5.5 inaugura la familia Claude 5.5. Anthropic lo presenta con un rendimiento cercano a Fable 5.1 en muchas tareas, mayor eficiencia que Opus 5 y mejoras al escribir y explicar su trabajo. El anuncio del 22 de septiembre de 2026 también anticipa Sonnet 5.5 y Haiku 5.5 para las semanas siguientes.
Para quienes usamos agentes, me interesa especialmente cómo se combinan esas mejoras. El modelo tiene que entender el encargo, trabajar con herramientas y entregarte algo que puedas revisar. Si además explica bien lo que hizo, seguir una sesión larga se vuelve mucho más llevadero.
Eso es lo que quiero mirar cuando sale un modelo: qué puedo construir con él y cuánto trabajo me queda después de que termina.
Fuente del lanzamiento: anuncio oficial de Anthropic y publicación de Claude en X.
Programación y trabajo profesional: el salto que muestran las pruebas
La tabla de Anthropic reporta avances de Opus 5.5 respecto de Opus 5 en distintas tareas:
| Evaluación | Opus 5 | Opus 5.5 |
|---|---|---|
| Terminal-Bench 4.0, programación con agentes | 52,3% | 66,4% |
| FrontierCode v1.1, programación | 48,0% | 54,4% |
| GDPval-AA v2.1, trabajo profesional | 1.708 Elo | 1.846 Elo |
| AutomationBench, flujos empresariales | 26,9% | 40,0% |
| OSWorld 2.0, uso del computador | 74,0% parcial | 81,8% parcial |
Son resultados publicados en el anuncio, con las condiciones de cada evaluación. No son pruebas que yo haya repetido. Terminal-Bench usa esfuerzo xhigh para Opus 5.5; las notas de la fuente detallan márgenes de error, herramientas y modelos de respaldo.
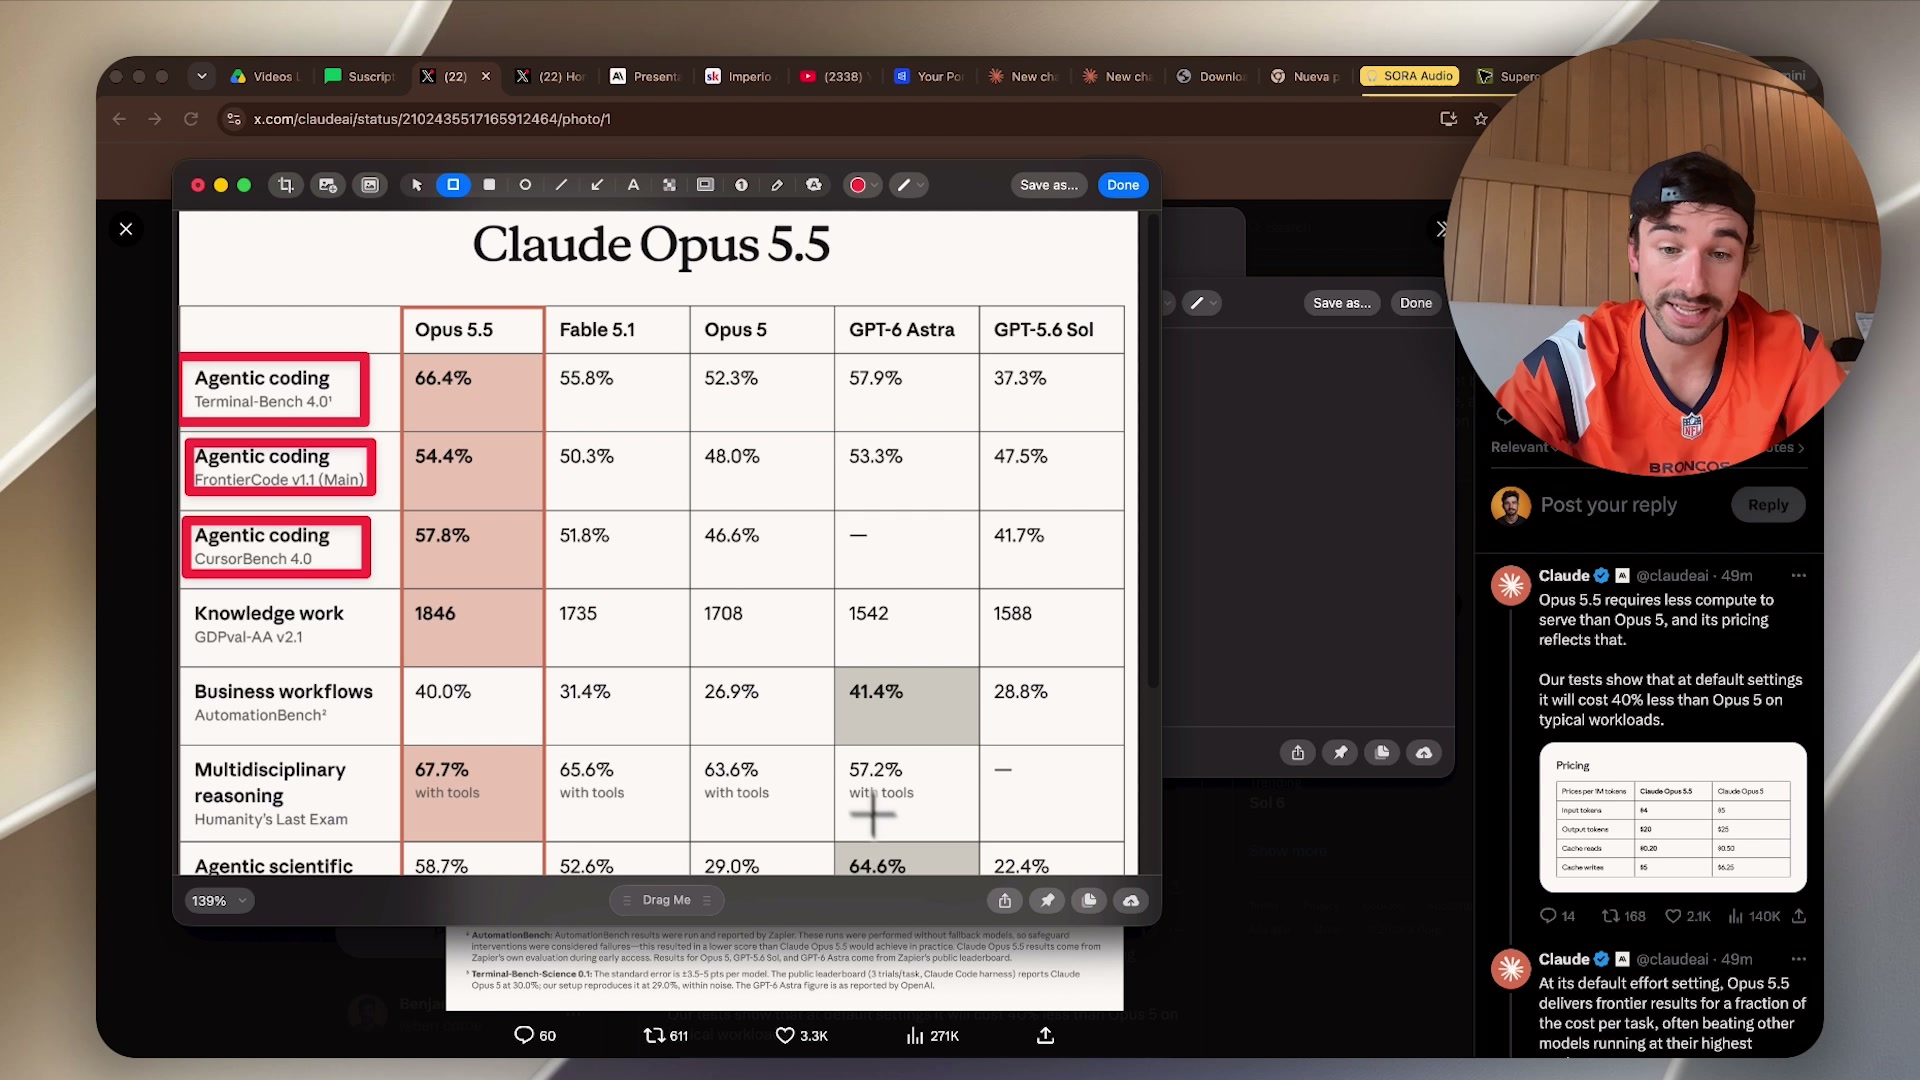
Terminal-Bench me interesa porque evalúa a un agente trabajando desde una terminal, con tareas que requieren varios pasos. GDPval apunta a entregables de trabajo profesional. AutomationBench, por su parte, se acerca a los flujos de negocio que muchos queremos automatizar.
Por eso conviene mirar varias filas. Crear una buena página, investigar y coordinar un proceso empresarial exigen capacidades distintas. La prueba relevante depende de lo que quieras resolver.
El precio: qué significa ese 40% menos
En la API estándar, Opus 5.5 cuesta US$4 por millón de tokens de entrada y US$20 por millón de salida. Las lecturas de caché cuestan US$0,20 por millón. Frente a Opus 5, la rebaja es del 20% en entrada y salida y del 60% en lecturas de caché.
El ahorro del 40% anunciado por Anthropic corresponde a sus cargas de trabajo típicas con la configuración predeterminada. Combina tarifas y consumo. No significa que cada tarea ni cada token cuesten exactamente un 40% menos.
Esta distinción importa cuando empiezas a dejar agentes trabajando durante más tiempo. La factura depende también del contexto que reutilizan, los pasos que dan y las veces que tienen que corregirse. Un precio por millón de tokens es solo una parte de la cuenta.
En mi prueba de la landing no medí una factura comparable entre los dos modelos. Lo que puedo mostrar es el entregable y cómo se comportó al abrirlo. Para decidir qué usar en un proceso recurrente, todavía hay que medir ese proceso concreto.
Uso del computador y comunicación
El 81,8% parcial de OSWorld 2.0 llama la atención, pero no significa que puedas dejar cualquier proceso completamente solo. Sirve para mirar el avance en esa evaluación; completar tu flujo real sigue siendo otra comprobación.
La comunicación también importa. En mi trabajo, explicar bien una decisión ayuda a detectar errores y revisar el resultado. La mejora útil aparece cuando entiendes qué pasó sin tener que reconstruir toda la conversación.
Voy a seguir probando esa parte con tareas de negocio. Una primera landing me permite evaluar el acabado visual, pero todavía quiero ver qué ocurre cuando el agente debe manejar más aplicaciones, datos y excepciones.
Lo probé: la página que me hizo decir wow
Mientras revisaba el anuncio dejé una tarea corriendo en Claude Code con Opus 5.5. Le pedí una landing de audífonos con imágenes, video y una vista explotada que avanzara al hacer scroll, conectado a Higgsfield para crear los recursos.
Para tener una referencia, le di el mismo prompt a GPT-6 Astra en Codex. Ambos estaban con sus niveles de razonamiento más altos. Astra terminó antes; al revisar las conversaciones estimé unos 21 minutos para Astra y unos 35 para Opus. Son tiempos aproximados de esta ejecución.
Cuando abrí la página de Opus... wow. Las imágenes, el movimiento al bajar y los colores del producto se sentían como una presentación completa. Creo que es la mejor página que he sacado con un prompt tan simple. Mi reacción quedó grabada.
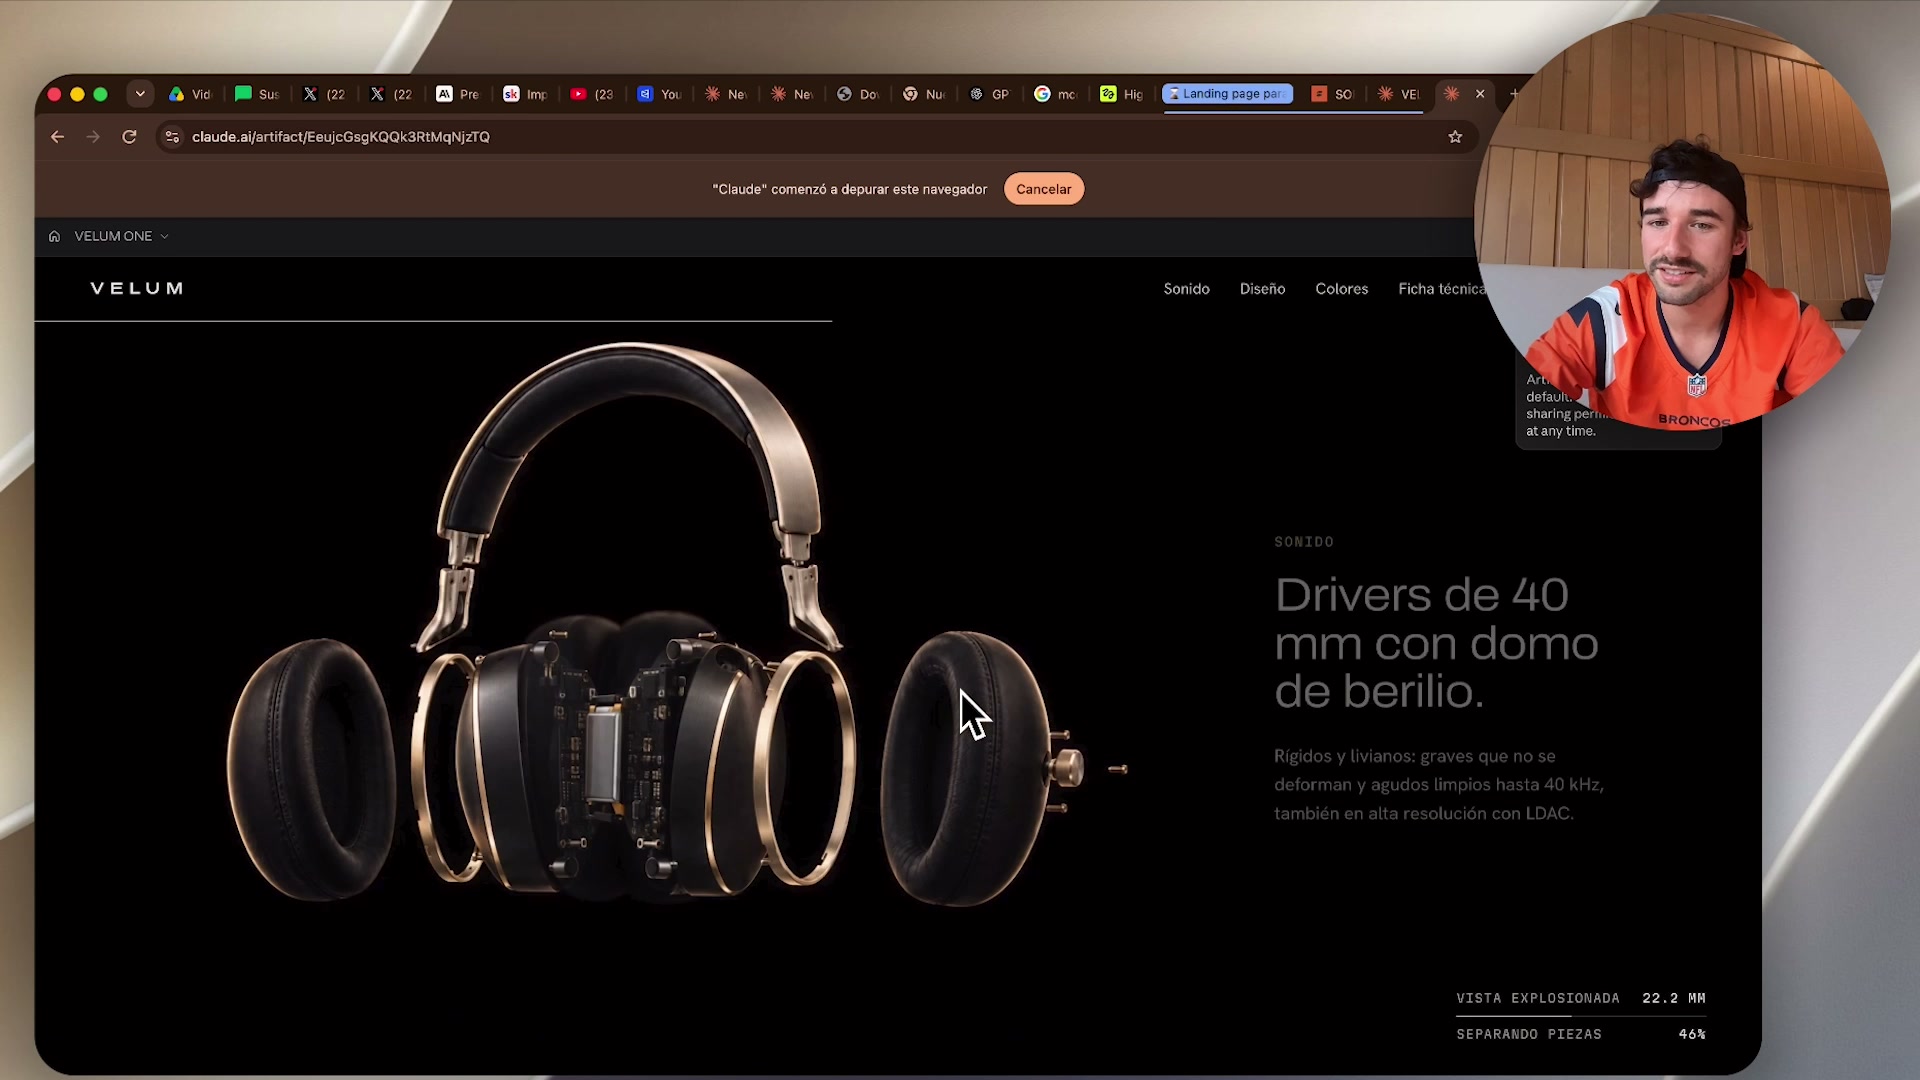
Puedes abrir la landing que creó Opus y recorrerla. También revisé cómo se adaptaba al cambiar el tamaño de la ventana. Esta fue una primera revisión visual, no una auditoría completa de rendimiento, accesibilidad o funcionamiento de todos los botones.
La prueba me dejó una buena primera impresión del modelo. No aísla al modelo de Claude Code, las herramientas ni los recursos generados, y tampoco convierte una ejecución en una conclusión para todos los usos.
Dónde quiero seguir probándolo
Hay dos filas del anuncio donde Astra conserva una puntuación superior: AutomationBench, con 41,4% frente a 40,0%, y Terminal-Bench-Science 0.1, con 64,6% frente a 58,7%. La evaluación científica reporta errores estándar de entre 3,5 y 5 puntos por modelo. Son referencias para seguir investigando, no una sentencia sobre cualquier tarea.
En programación y acabado visual, Opus 5.5 me dio muchas ganas de volver a usarlo. En automatización de negocios quiero llevarlo a más casos antes de decidir dónde encaja mejor.
Si lo vas a probar, toma una tarea que conozcas bien. Revisa el resultado, las correcciones que necesita y el tiempo que te ahorra a ti. Esa es la parte que termina pesando cuando incorporas una herramienta a tu trabajo.
Mi primera impresión es muy buena. Anthropic volvió con un lanzamiento que vale la pena descomponer y, sobre todo, poner a trabajar.
Video completo y recursos
En el video abro el anuncio, explico los benchmarks, reviso los precios y muestro las páginas funcionando. Puedes continuar con la biblioteca de Claude Code o con el curso completo de Codex.
En Imperio Agéntico compartimos estas pruebas y trabajamos en cómo aplicarlas a proyectos reales.
Por Benjamín Cordero, creador de @bencord y cofundador de Imperio Agéntico junto a Maximiliano Cordero.
Preguntas frecuentes
Qué cambia con Claude Opus 5.5?
El lanzamiento presenta mejoras en programación con agentes, trabajo profesional y eficiencia respecto de Opus 5. En esta guía separo los resultados publicados por Anthropic de mi primera prueba práctica.
Cuánto cuesta Opus 5.5 en la API?
Las tarifas estándar del lanzamiento son US$4 por millón de tokens de entrada, US$20 por millón de salida y US$0,20 por millón de tokens leídos de caché. El costo final depende del consumo de la tarea y de la modalidad usada.
El ahorro del 40% se aplica a todos los tokens?
No. Anthropic lo reporta para cargas de trabajo típicas con su configuración predeterminada. Las tarifas de entrada y salida bajan un 20% respecto de Opus 5; el ahorro total también depende del consumo y la caché.
Qué tarea probé con Opus 5.5?
Una landing de audífonos con imágenes, video y una vista explotada al hacer scroll, usando Claude Code conectado a Higgsfield. Como referencia, probé el mismo prompt con GPT-6 Astra en Codex.
Dónde puedo ver la página que creó Opus?
La sección de la prueba incluye un enlace a la landing pública de Claude y el video completo, donde se ve el resultado funcionando y mi reacción.