
Tenía una reunión en mi calendario y Dots investigó a la persona y su empresa antes de que yo se lo pidiera. Me dejó un pequeño brief con contexto para llegar preparado. Ese fue uno de los momentos en que empecé a verle sentido.
Lo probé durante 72 horas. También le encargué ideas de contenido, miniaturas con Higgsfield y un brief que termina impreso en mi oficina. Hubo cosas que me sirvieron bastante y otras que todavía se sienten a medio terminar.
Mi opinión parte de esas pruebas, recogidas en el video publicado el 5 de octubre de 2026. El balance es sencillo: me está ayudando a detectar y anticipar trabajo; para varios encargos concretos sigo prefiriendo Codex o Claude Code.
Lo que hizo sin que yo abriera otro chat
La preparación de la reunión es el ejemplo más claro. El evento estaba en Google Calendar. Dots ya tenía acceso al contexto y se adelantó con una investigación que yo habría tenido que pedir o hacer por mi cuenta.
También detectó una oportunidad de contenido a partir de la transcripción de una sesión de soporte y me señaló un correo que valía la pena revisar. Me interesa esa capacidad de conectar lo que pasa en distintas partes de mi trabajo.
Después lo llevé a algo más tangible: un brief agéntico con propuestas para el canal, impreso cuando llego a la oficina. En el video muestro la hoja. Esa entrega ya forma parte de una rutina que fui configurando; no apareció una impresora conectada por arte de magia.
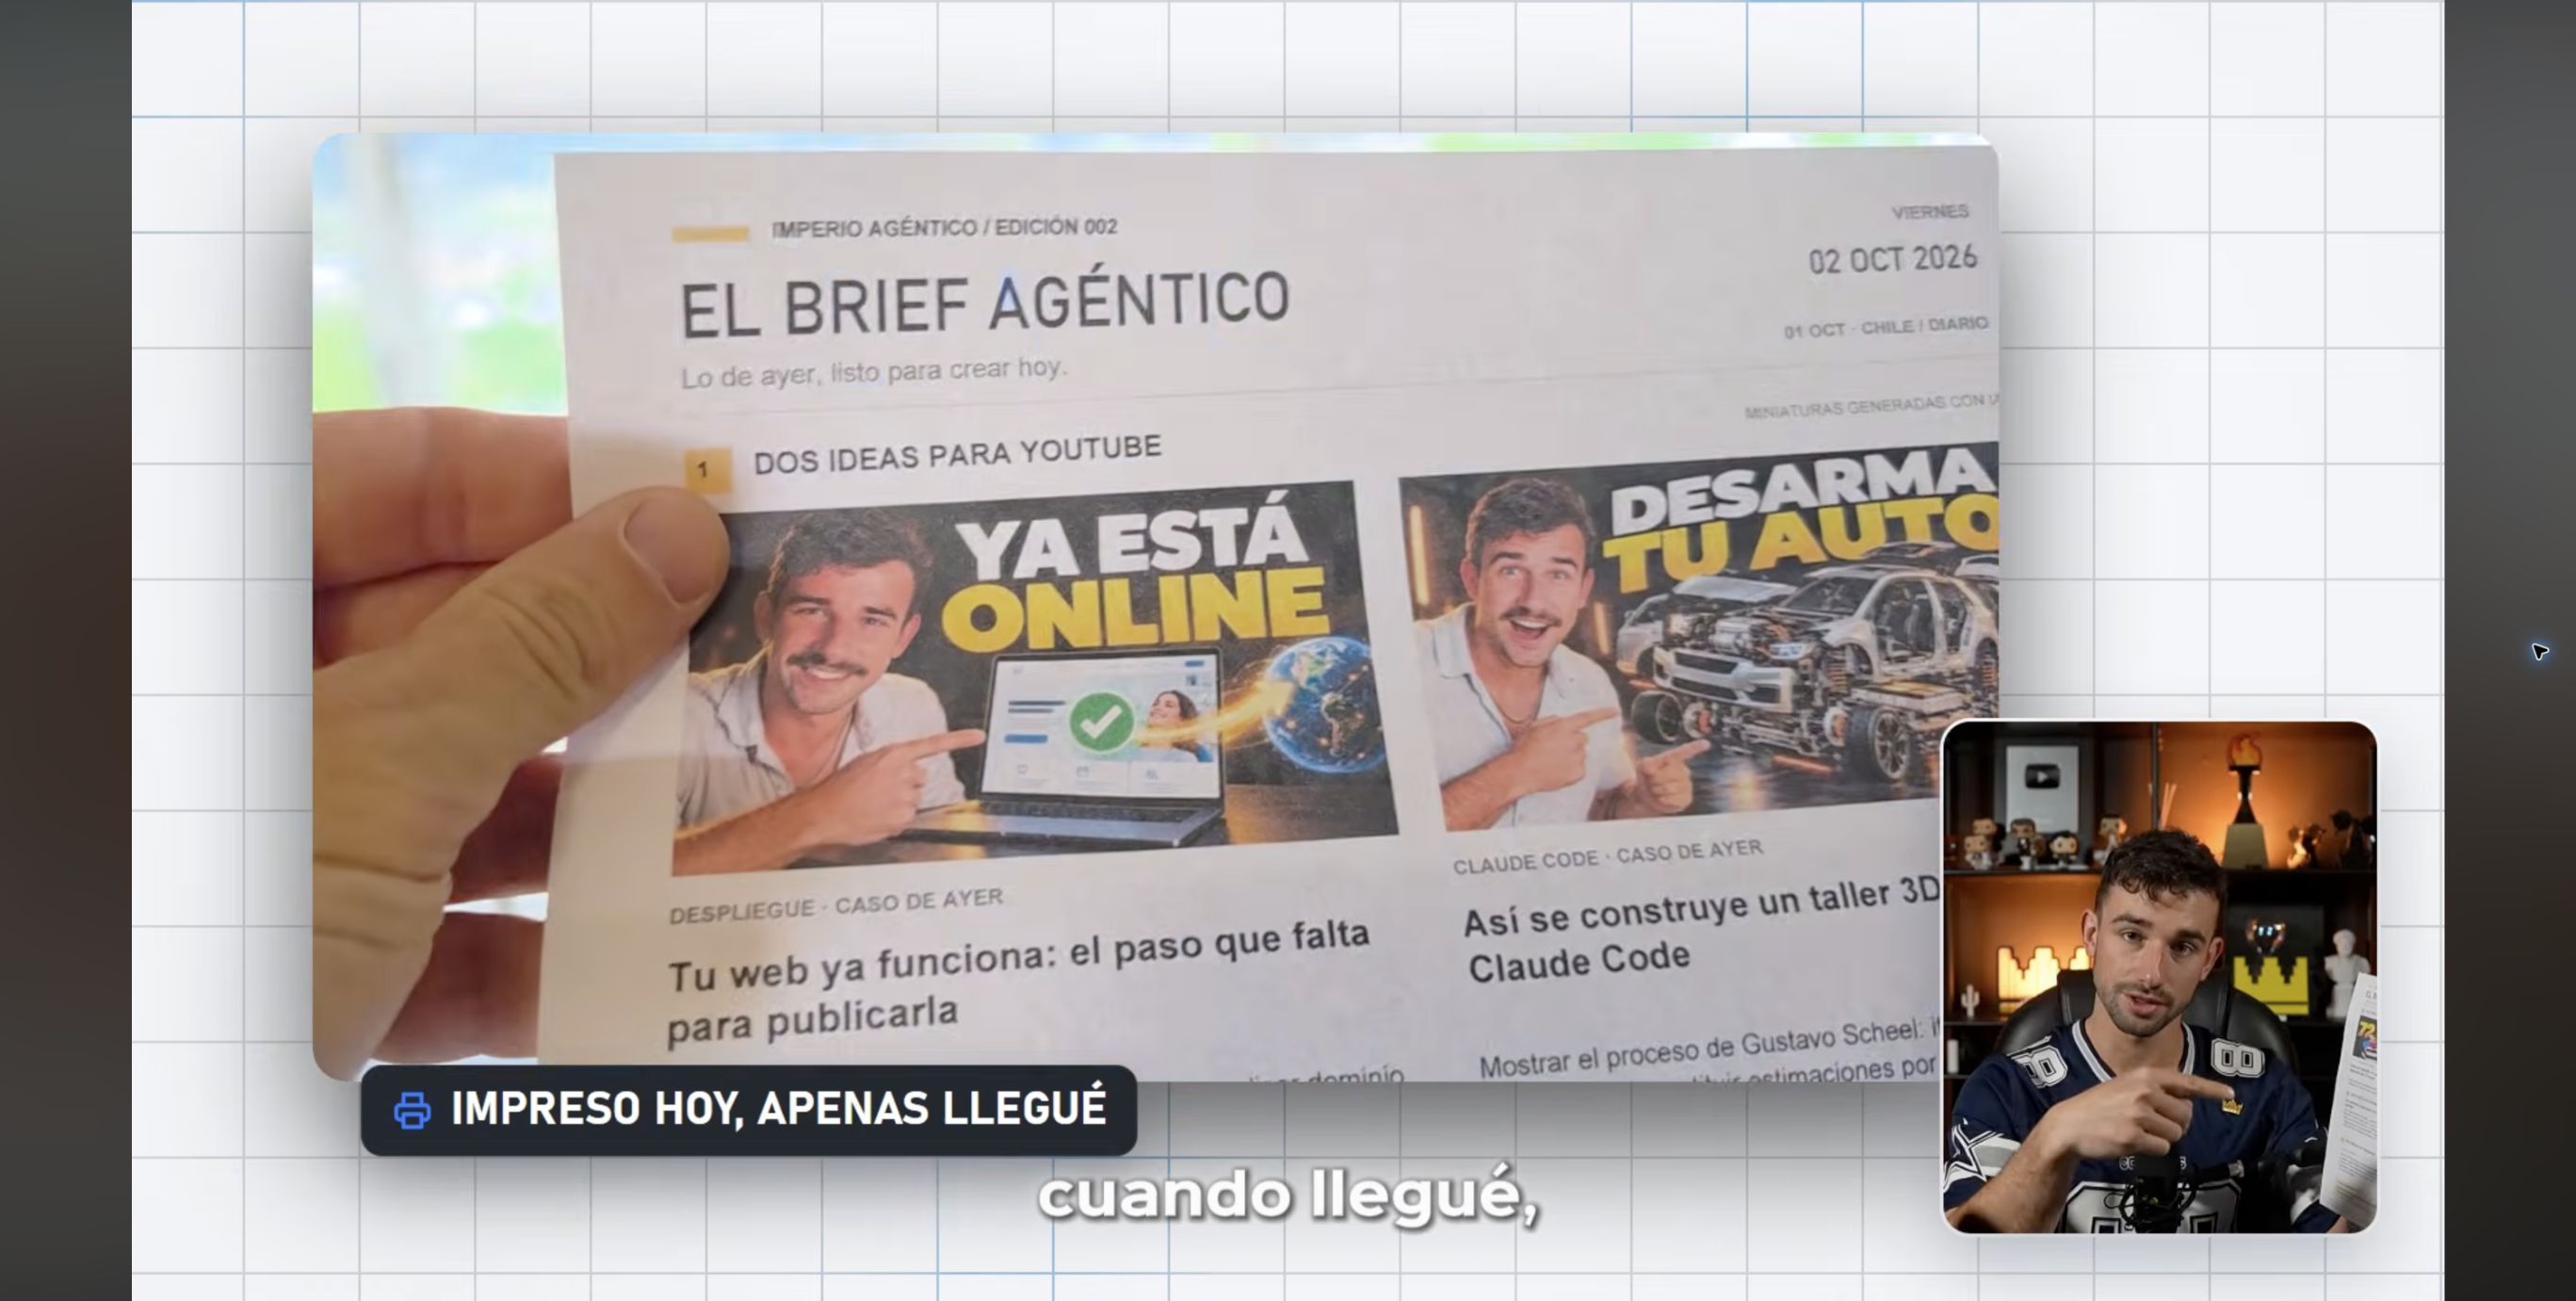
Para mí, el valor está en recibir algo que puedo revisar y usar. Si cada propuesta es genérica o repite lo que ya vi, termino con otra lista de pendientes. Por eso importa tanto enseñarle qué información me sirve.
Qué es Dots y qué cambia al tener su propio computador
Al mío le puse Dotín. Además del personaje que aparece en la aplicación, hay un entorno con navegador, archivos y herramientas para ejecutar trabajo. En la demostración entro a ese computador y le encargo tareas de navegación.
La presentación oficial de OpenAI describe Dots como agentes con su propio computador en la nube, conectados a las aplicaciones que autorizas. También permite conectar otros dispositivos. Esa distinción importa: el trabajo en la nube puede continuar sin tu portátil, pero acceder a archivos o equipos locales necesita que ese entorno esté disponible.
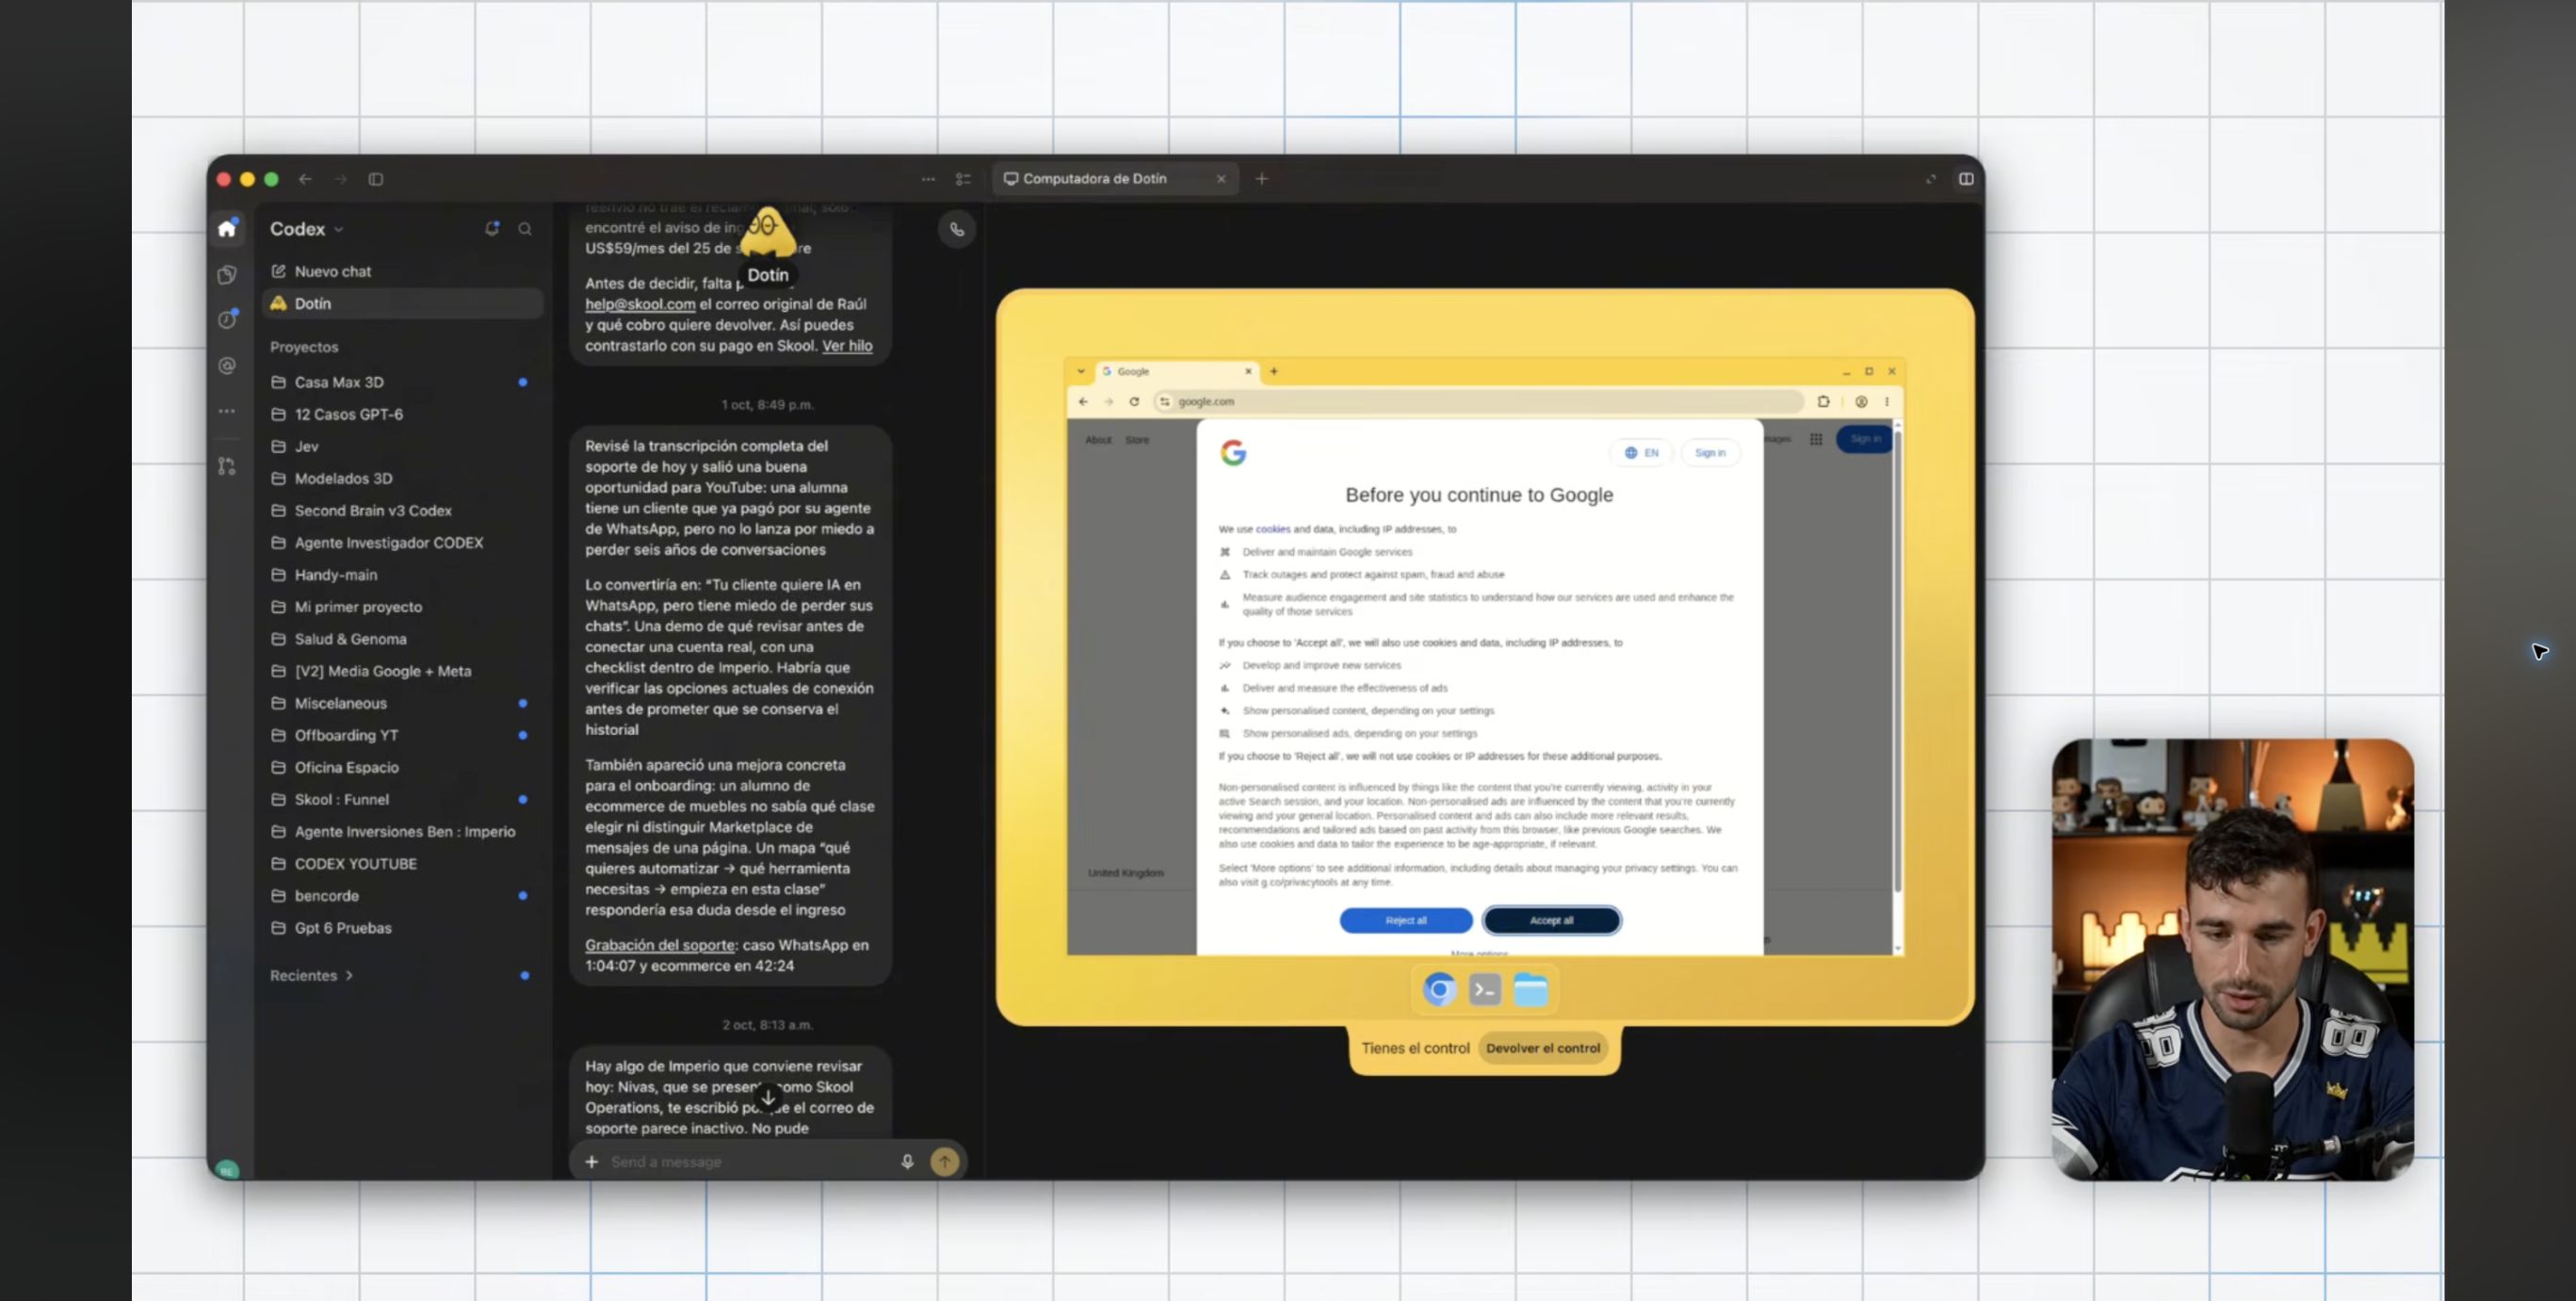
En mi prueba puedo tomar el control para entrar a una cuenta y devolvérselo. Es cómodo, aunque una sesión de navegador puede caducar. Si una tarea depende de ella, conviene comprobar cómo se recupera cuando vuelve a pedir inicio de sesión.
Darle una responsabilidad y definir cuándo debe volver
Le veo más sentido a decirle que me ayude a llegar preparado a las reuniones que a reconstruir la misma petición antes de cada llamada. La responsabilidad continúa; la información que necesita cambia.
En el video separo tres ideas. Una tarea programada tiene una hora y un encargo, como preparar un brief cada mañana. Un heartbeat revisa periódicamente si cambió algo y si hay trabajo útil que adelantar. Un evento puede activar una tarea cuando una conexión lo permite.
La frecuencia de 30 segundos que menciono es un ejemplo para explicar el mecanismo, no una especificación comprobada de Dots. Tampoco toda automatización programada demuestra iniciativa: una rutina que yo dejé configurada sigue siendo una rutina.
Hay otro matiz en la documentación actual: OpenAI describe su investigación proactiva en segundo plano con herramientas de solo lectura. Esa investigación no puede enviar mensajes, cambiar contenido en aplicaciones ni controlar el navegador o el computador. Ejecutar tareas autorizadas y publicar resultados son pasos distintos.
Mi prueba con X y miniaturas de Higgsfield
Le pedí que buscara un tema en tendencia en X relacionado con IA, propusiera una idea de título y generara una miniatura con Higgsfield. Después le indiqué una entrega diaria y le pedí una prueba en ese momento.
El primer resultado llegó, pero todavía no tenía el nivel que quería. Entonces le pedí que revisara las referencias de miniaturas en mi carpeta de Codex y aprendiera de ese trabajo para las siguientes entregas.
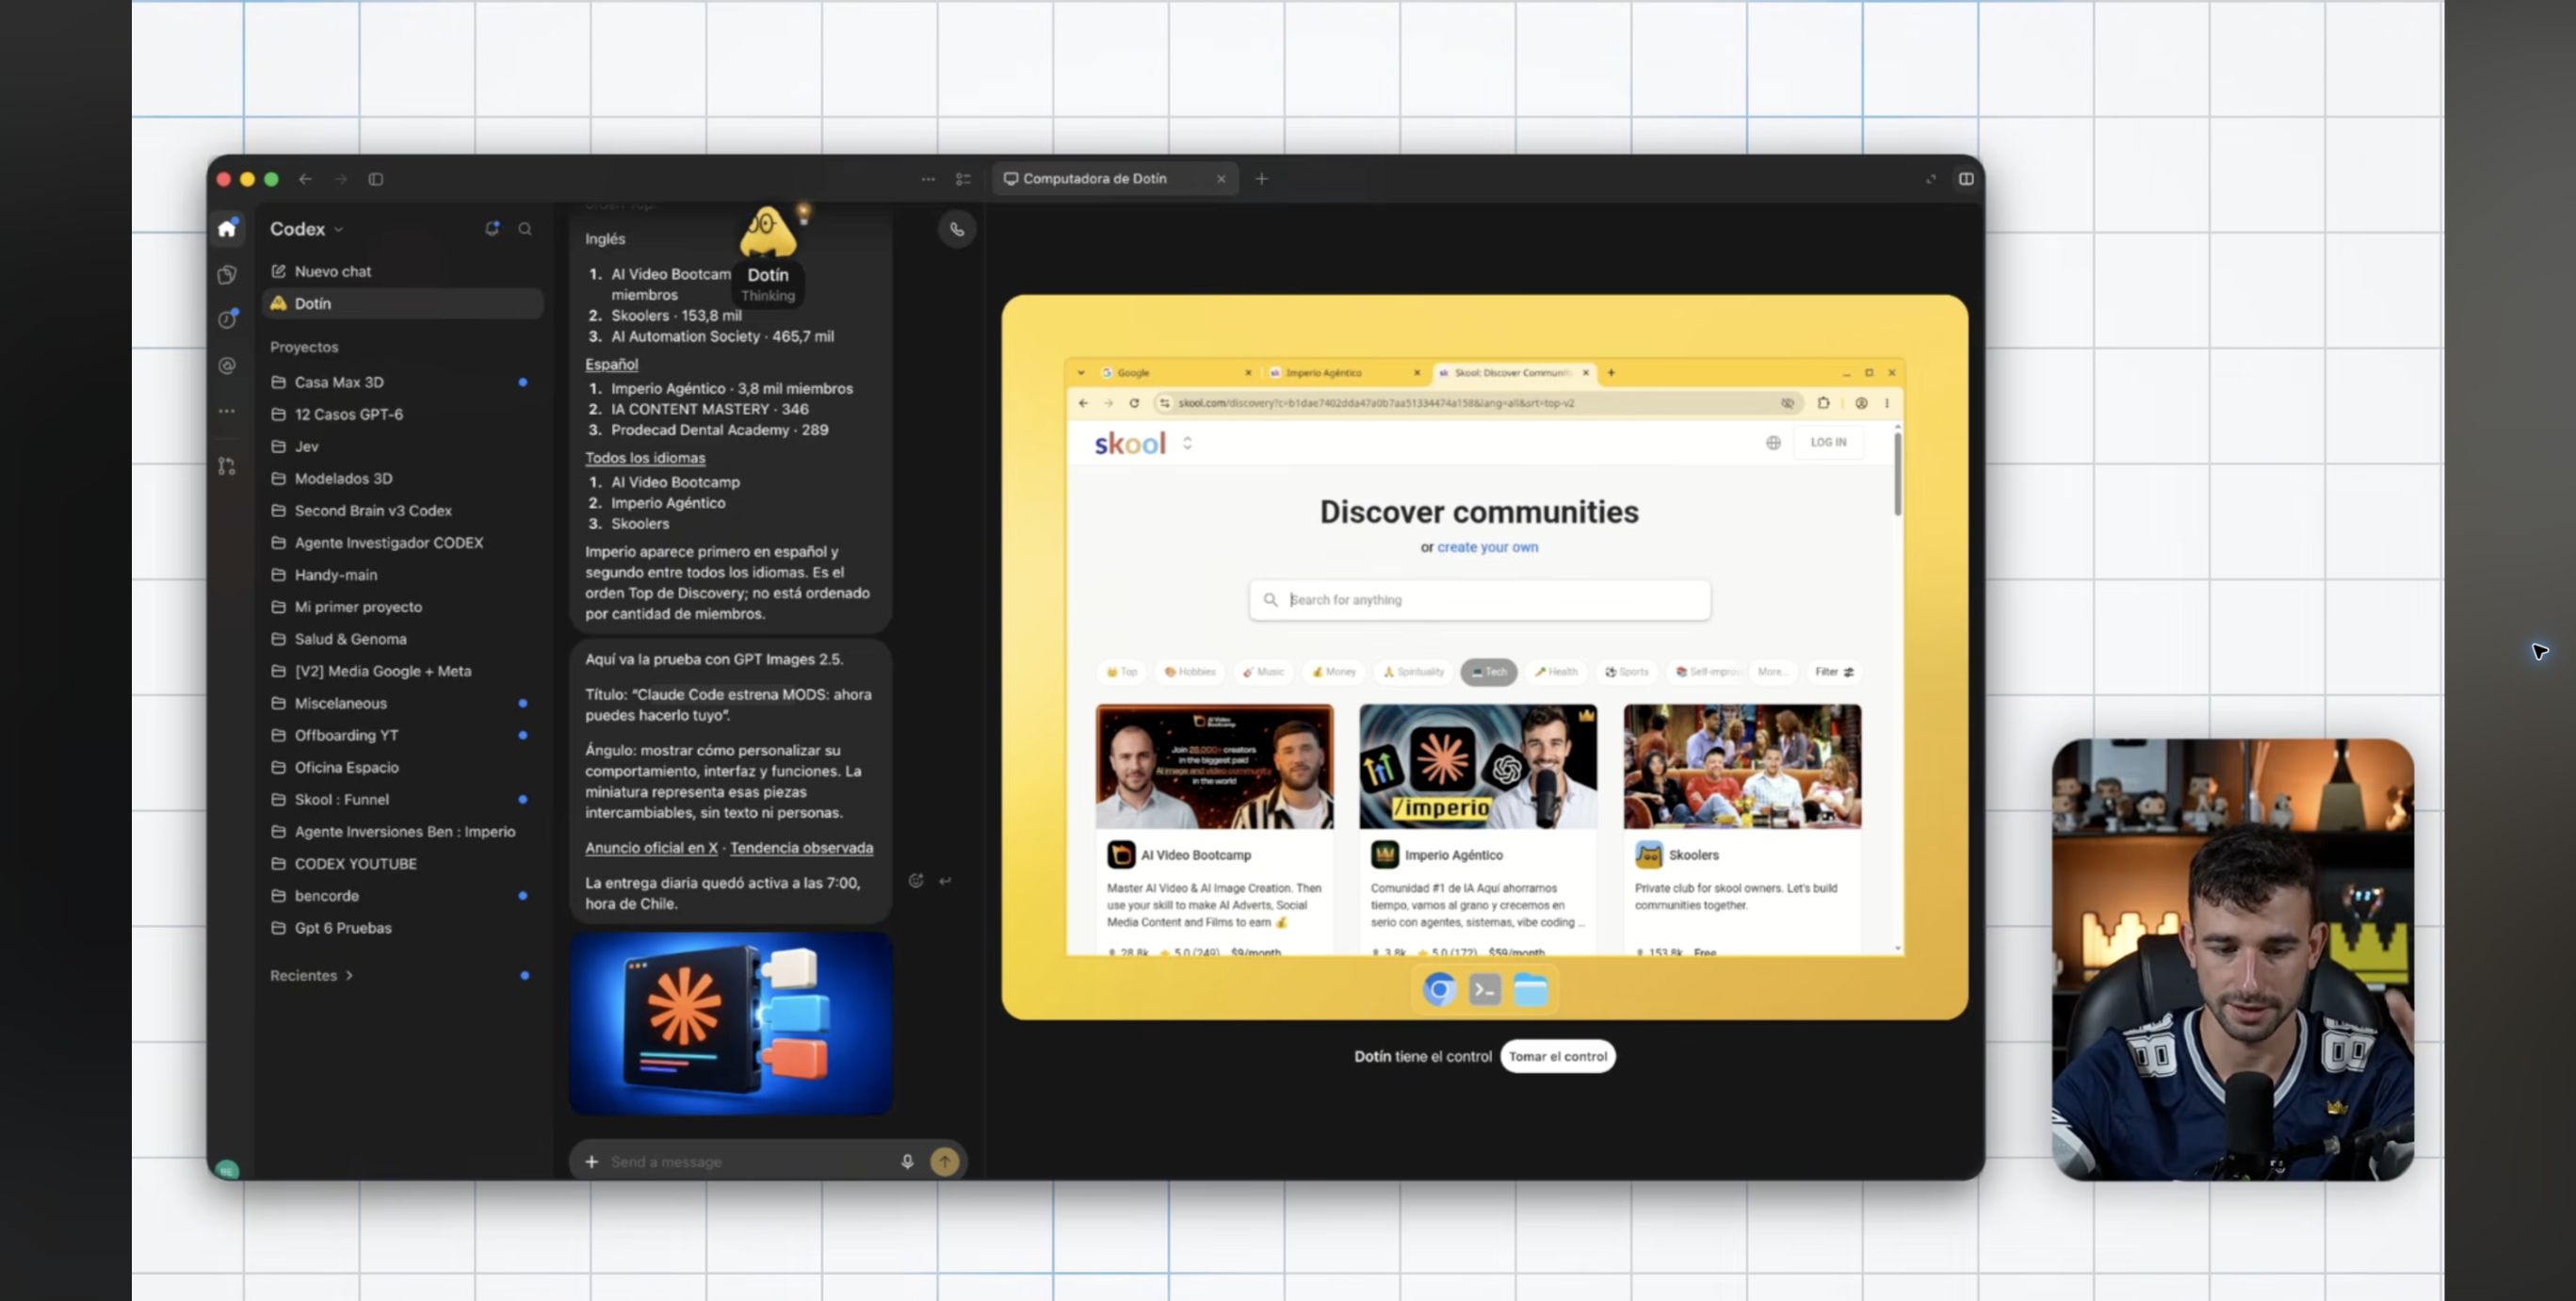
Esa corrección es parte del proceso. Tener acceso a un generador de imágenes no le enseña por sí solo qué miniaturas funcionan para mi canal. Necesita ejemplos, contexto y comentarios concretos.
Mientras avanzaba con esa tarea, le pedí otra consulta de navegación en paralelo. Me gustó poder seguir encargándole trabajo sin esperar a que terminara cada paso. Aun así, revisé lo que devolvía antes de usarlo.
Lo que todavía me frena
La voz no me funcionó durante la prueba. Intenté llamarlo y no respondió. Es una función que me interesaba mucho, así que la experiencia quedó por debajo de lo que esperaba. Eso describe mis intentos en esas primeras 72 horas, no una afirmación de que vaya a fallarle a todo el mundo.
La velocidad y la navegación tienen margen de mejora. Para algunos encargos específicos la experiencia todavía me resulta menos fluida que trabajar directamente con Codex o Claude Code. El hecho de que pueda hacer muchas cosas no significa que sea la mejor herramienta para cada una.
La memoria necesita mantenimiento. Encontré contexto antiguo que ya no reflejaba mi situación. Si el agente toma iniciativa sobre información desactualizada, también se equivoca en lo que considera prioritario. Antes de darle más responsabilidades, revisaría qué cree saber de mí.
Hay que mirar el uso real. En el video hablo del consumo de créditos. La documentación actual distingue las conversaciones con el Dot del trabajo que inicia o gestiona en Codex o ChatGPT Work: esas tareas cuentan para los límites correspondientes. No asumiría que toda la actividad tiene el mismo costo o la misma cuota. La fuente oficial detalla ese alcance.
Dots frente a los agentes que ya uso
Grok Bot me ha resultado más natural para algunas tareas cotidianas. Dots me interesa especialmente cuando encuentra algo que debería atender o prepara contexto antes de una reunión. Es una preferencia surgida de mi uso, no un benchmark entre modelos.
En Codex o Claude Code suelo entrar con un trabajo más delimitado: una carpeta, un proyecto y un resultado que quiero construir o corregir. Dots sigue responsabilidades más amplias. Esa amplitud puede ayudar, pero también exige buen criterio para elegir qué traerme.
Si ya tienes OpenClaw, Hermes u otro agente resolviendo bien tu flujo, yo no empezaría de cero solo porque salió una interfaz nueva. Y sobre Muse, en esta grabación todavía no lo había probado: no lo presento como una comparación propia.
Cómo partiría después de estas 72 horas
Elegiría una sola responsabilidad que ya exista en mi día a día. Preparar reuniones, seguir un proyecto o traer una propuesta de contenido cada mañana son buenos ejemplos de lo que quise probar.
Después le mostraría qué considero una buena entrega y qué descartaría. Revisaría las primeras, corregiría la memoria que esté antigua y dejaría claros los pasos que requieren mi aprobación.
Mi veredicto es que hay una idea potente y momentos donde ya me ayudó. Quiero seguir usándolo por lo que puede anticipar, sin dar por resueltos los problemas que encontré. El criterio será si me deja trabajo útil preparado y me devuelve atención para lo demás.
Si quieres implementar agentes y automatizaciones con casos reales, puedes conocer Imperio Agéntico. Para profundizar en las herramientas que comparo, están el curso de Codex y el curso de Claude Code.
Capítulos del video
0:00 Lo que Dots hizo sin que se lo pidiera
1:33 Qué intenta hacer OpenAI con esto
2:46 Dots en el DevDay de OpenAI
3:10 Cómo crear y personalizar tu Dot
3:47 Su propio computador en la nube
6:08 Agente proactivo vs reactivo
8:18 Dots vs OpenClaw, Hermes, Grok Bot y Muse
10:21 Por qué lo lanzaron apurado
11:22 Dots vs Codex y Claude Code
12:46 Tareas programadas y heartbeat
14:36 Llamadas de voz y Slack
16:13 Caso real: miniaturas diarias con Higgsfield
19:46 Tareas en paralelo y más casos de uso
23:07 Créditos y lo que todavía le falta
25:53 Mi veredicto después de 72 horas
Por Benjamín Cordero, creador del canal y cofundador de Imperio Agéntico junto a Maximiliano Cordero.
Preguntas frecuentes
¿Para qué me sirvió ChatGPT Dots durante la prueba?
Me preparó contexto para una reunión sin que yo solicitara ese informe. También lo usé para ideas de contenido, un brief impreso y una prueba de miniaturas con Higgsfield.
¿Qué falló en mis primeras 72 horas con Dots?
Las llamadas de voz no me funcionaron y encontré margen de mejora en velocidad y navegación. También revisaría las sesiones de las cuentas conectadas y la vigencia de su memoria.
¿Dots sustituye a Codex o Claude Code?
En mi experiencia cumplen papeles distintos. Dots me interesa para seguir responsabilidades y anticipar trabajo; para varios encargos concretos sigo prefiriendo Codex o Claude Code.
¿Por dónde empezaría a probar Dots?
Por una sola responsabilidad útil, como preparar reuniones, con ejemplos de una buena entrega, contexto actualizado y revisión de los primeros resultados.