
Anthropic lanzó Claude Haiku 5.5 el 7 de octubre de 2026. Ya tenemos Opus, Sonnet y Haiku en la familia 5.5, y yo sigo esperando a Fable. Pero mientras llega esa respuesta, quise probar lo que ya podemos usar: el modelo pequeño que compite directamente con GPT-6 Luna.
Armé un buscaminas y los puse a jugar. Primero hice una prueba en vivo; después, una evaluación de 20 partidas por modelo. Quería mirar cuánto tardan, cuánto cuestan y cuántas veces se equivocan. Porque responder rápido y pisar una mina tampoco nos sirve mucho.
Haiku terminó las 20 partidas y tocó dos minas. Luna ganó 15 y tocó 26. Hay una diferencia clara en esta ejecución, aunque también hay matices: Luna fue más rápido y tuvo un costo menor. Esa combinación es la que conviene entender antes de cambiar el modelo de un agente.
Qué trae el nuevo Haiku
El anuncio de Anthropic lo sitúa en tareas frecuentes y acotadas: resumir información, compactar conversaciones, consultar bases de datos, clasificar y apoyar a modelos mayores como subagente. También destaca su uso en soporte y navegación cuando importa la latencia.
La empresa estima que ejecutarlo cuesta, en promedio, alrededor de un 75% menos que Haiku 4.5. Eso es una estimación de uso que considera consumo de tokens y tipos de solicitudes. No equivale a decir que cada llamada, con cualquier contexto, tendrá exactamente ese ahorro.
Para mí, la oportunidad está en esos pasos que una aplicación repite miles de veces. Si cada paso lo mandamos al modelo más caro, el costo se acumula aunque la tarea sea sencilla. Haiku se vuelve interesante cuando puede resolver bien ese tramo concreto del trabajo.
Los benchmarks: dónde queda frente a Luna
En las pruebas del anuncio donde aparecen ambos modelos, Haiku queda por encima de GPT-6 Luna. Estos son algunos de los resultados publicados por Anthropic:
| Evaluación | Haiku 5.5 | GPT-6 Luna | Qué ayuda a mirar |
|---|---|---|---|
| GDPval-AA v2.1 | 1620 | 1437 | Entregables de trabajo profesional |
| AA-Briefcase v1.1 | 1578 | 1336 | Trabajo con conjuntos de información |
| OSWorld 2.1, subconjunto offline | 72,4% | 48,9% | Uso del computador |
| Terminal-Bench 4.0 | 39,2% | 16,4% | Tareas técnicas en terminal |
| FrontierCode 1.1, Main | 46,4% | 42,4% | Trabajo de código |
| Chartography, sin herramientas | 46,4% | 29,1% | Interpretación de gráficos |
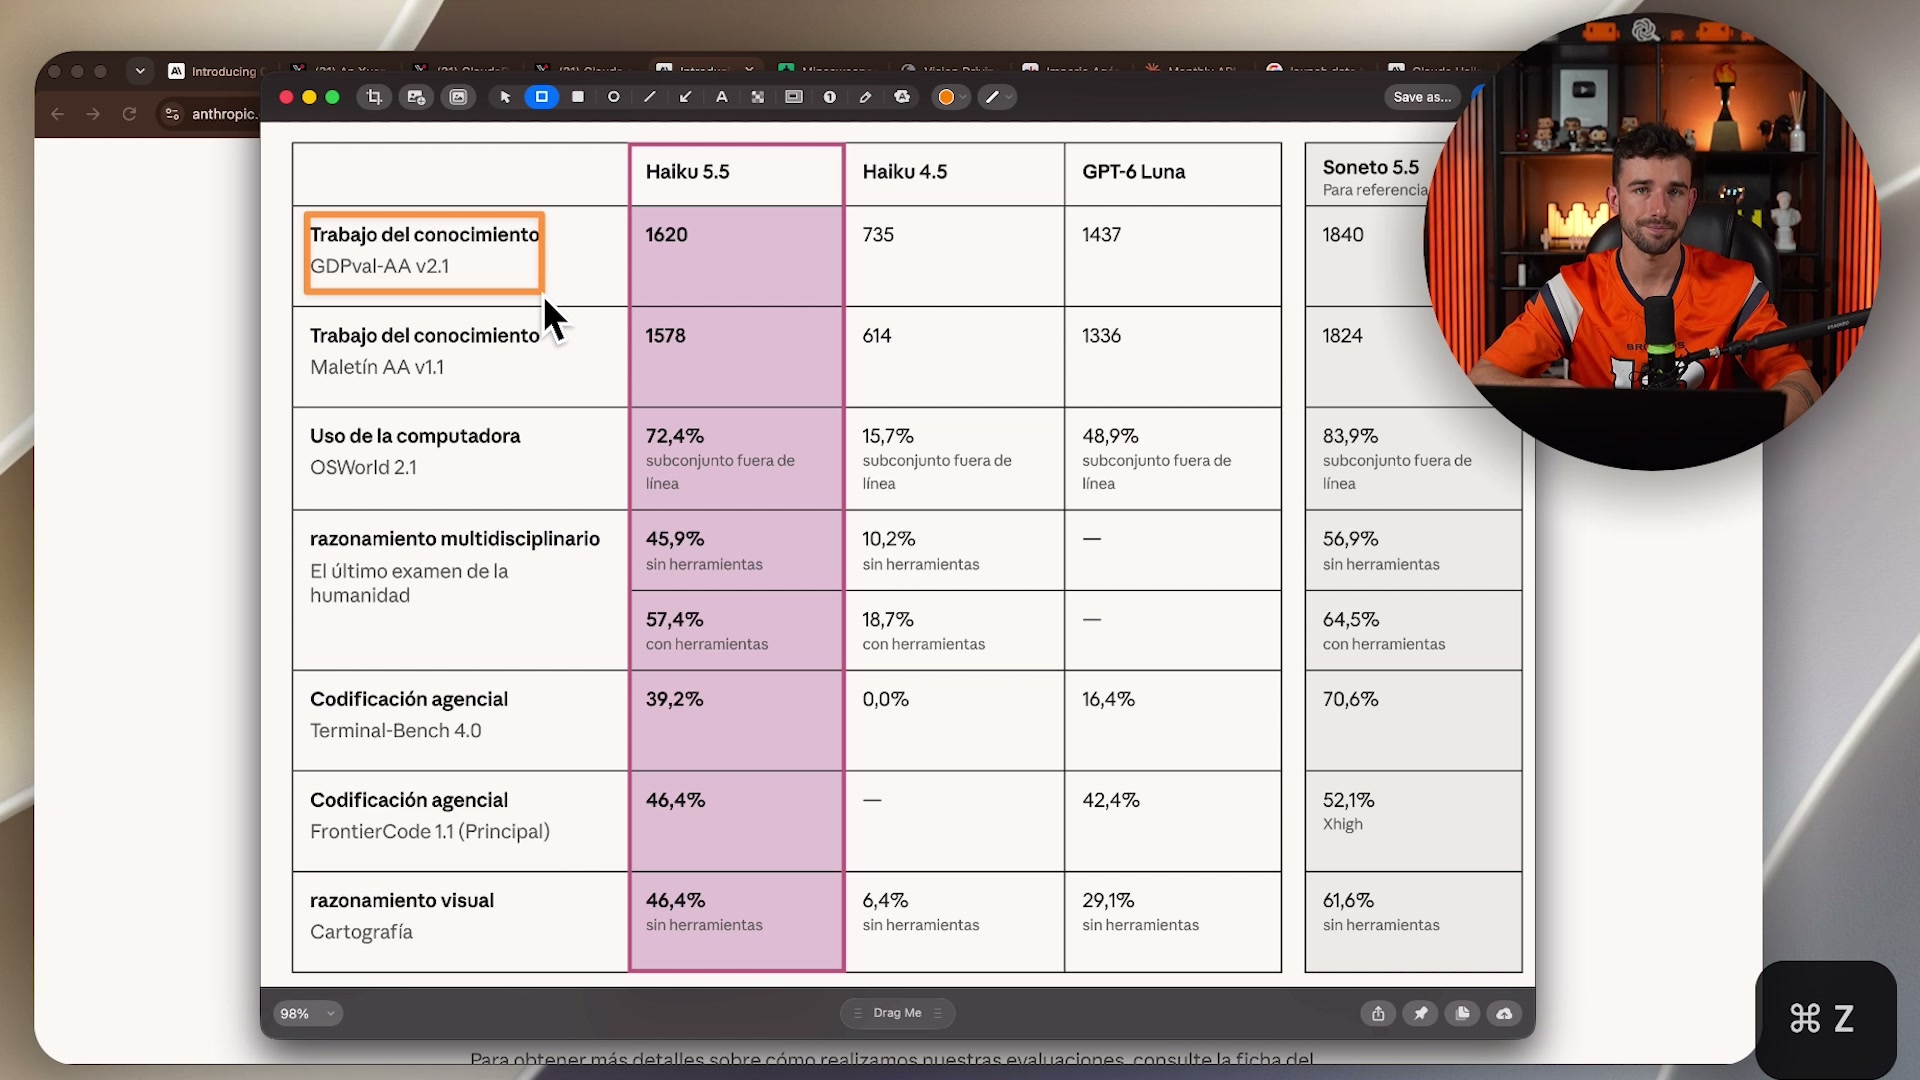
Los nombres y las versiones importan. Un resultado de Terminal-Bench 4.0 no se intercambia con otro de una versión anterior. Tampoco un porcentaje en OSWorld garantiza que el agente vaya a completar cualquier encargo en el navegador.
Sonnet sigue por delante en distintas pruebas exigentes del mismo anuncio. La lectura útil es decidir qué nivel de capacidad necesita cada parte del flujo y comprobarlo con ejemplos propios.
Precios: el detalle de los 100.000 tokens
Para solicitudes de hasta 100.000 tokens de entrada, Haiku 5.5 cuesta US$0,10 por millón de tokens de entrada y US$0,50 por millón de salida. Son las mismas tarifas que publica OpenAI para GPT-6 Luna en contexto corto y modalidad Standard.
La comparación cambia con contexto largo:
| Modelo y tramo | Entrada, por millón | Salida, por millón |
|---|---|---|
| Haiku 5.5, hasta 100.000 tokens de entrada | US$0,10 | US$0,50 |
| Haiku 5.5, más de 100.000 tokens de entrada | US$0,50 | US$2,50 |
| GPT-6 Luna, contexto corto Standard | US$0,10 | US$0,50 |
| GPT-6 Luna, contexto largo Standard | US$0,20 | US$0,75 |
Fuentes: tarifas de Haiku y precios de la API de OpenAI, consultados el 7 de octubre de 2026. Cada proveedor define sus tramos; conviene comprobar cómo se aplica el suyo a la solicitud concreta.
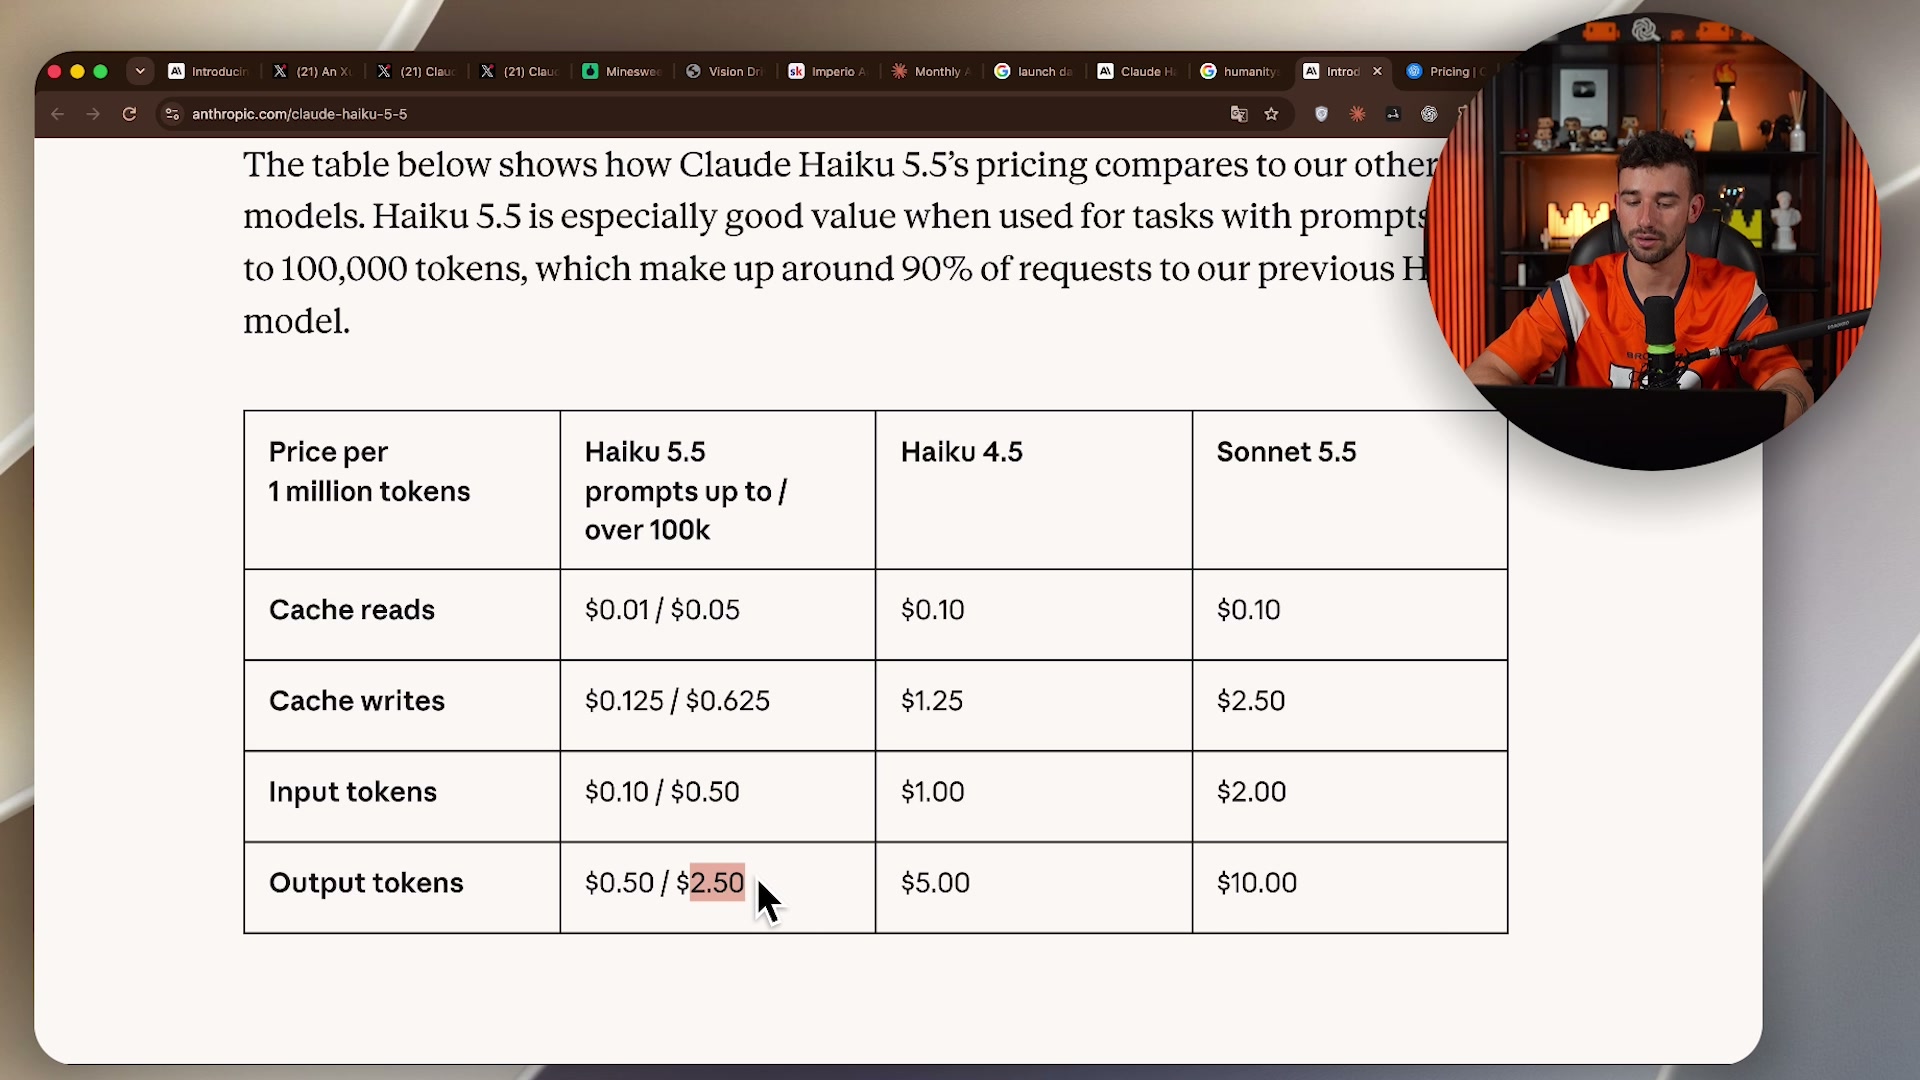
El precio por token tampoco cuenta toda la historia. La cantidad de pasos, el razonamiento y las repeticiones pueden cambiar el total. Por eso, que dos modelos tengan la misma tarifa no significa que terminarán una tarea por el mismo monto.
En el video hago una cuenta ilustrativa: 10.000 solicitudes de 1.000 tokens de entrada y 100 de salida sumarían US$1,50 con esas tarifas cortas. Es una cuenta con cantidades fijas, no el costo medido de ejecutar un flujo real.
Mi prueba de 20 partidas de buscaminas
La evaluación usa tableros de 10 × 10, 15 minas y tres vidas por partida, con 20 partidas por modelo y una semilla base común. Haiku, Luna y Sonnet aparecen con razonamiento bajo y acceso al tablero mediante herramientas. Jev y Decisions API usan preguntas de clasificación, así que su forma de interactuar es distinta.
La tabla guardada de esa ejecución muestra:
| Modelo | Ganadas | Minas tocadas | Tiempo medio por partida | Costo total indicado |
|---|---|---|---|---|
| Haiku 5.5 | 20/20 | 2 | 2:03 | US$0,485809 |
| GPT-6 Luna | 15/20 | 26 | 1:43 | US$0,319162 |
| Sonnet 5.5 | 20/20 | 0 | 1:57 | US$7,289694 |
| Jev 1.13 | 20/20 | 6 | 0:12 | US$0,036384 |
| Luna mediante Decisions API | 15/20 | 29 | 0:07 | US$0,074653 |
Son los costos que indica el panel de la prueba. Los tiempos son promedios por partida, no la duración total de la evaluación. Como hay tres vidas, un modelo puede ganar una partida aunque toque alguna mina.
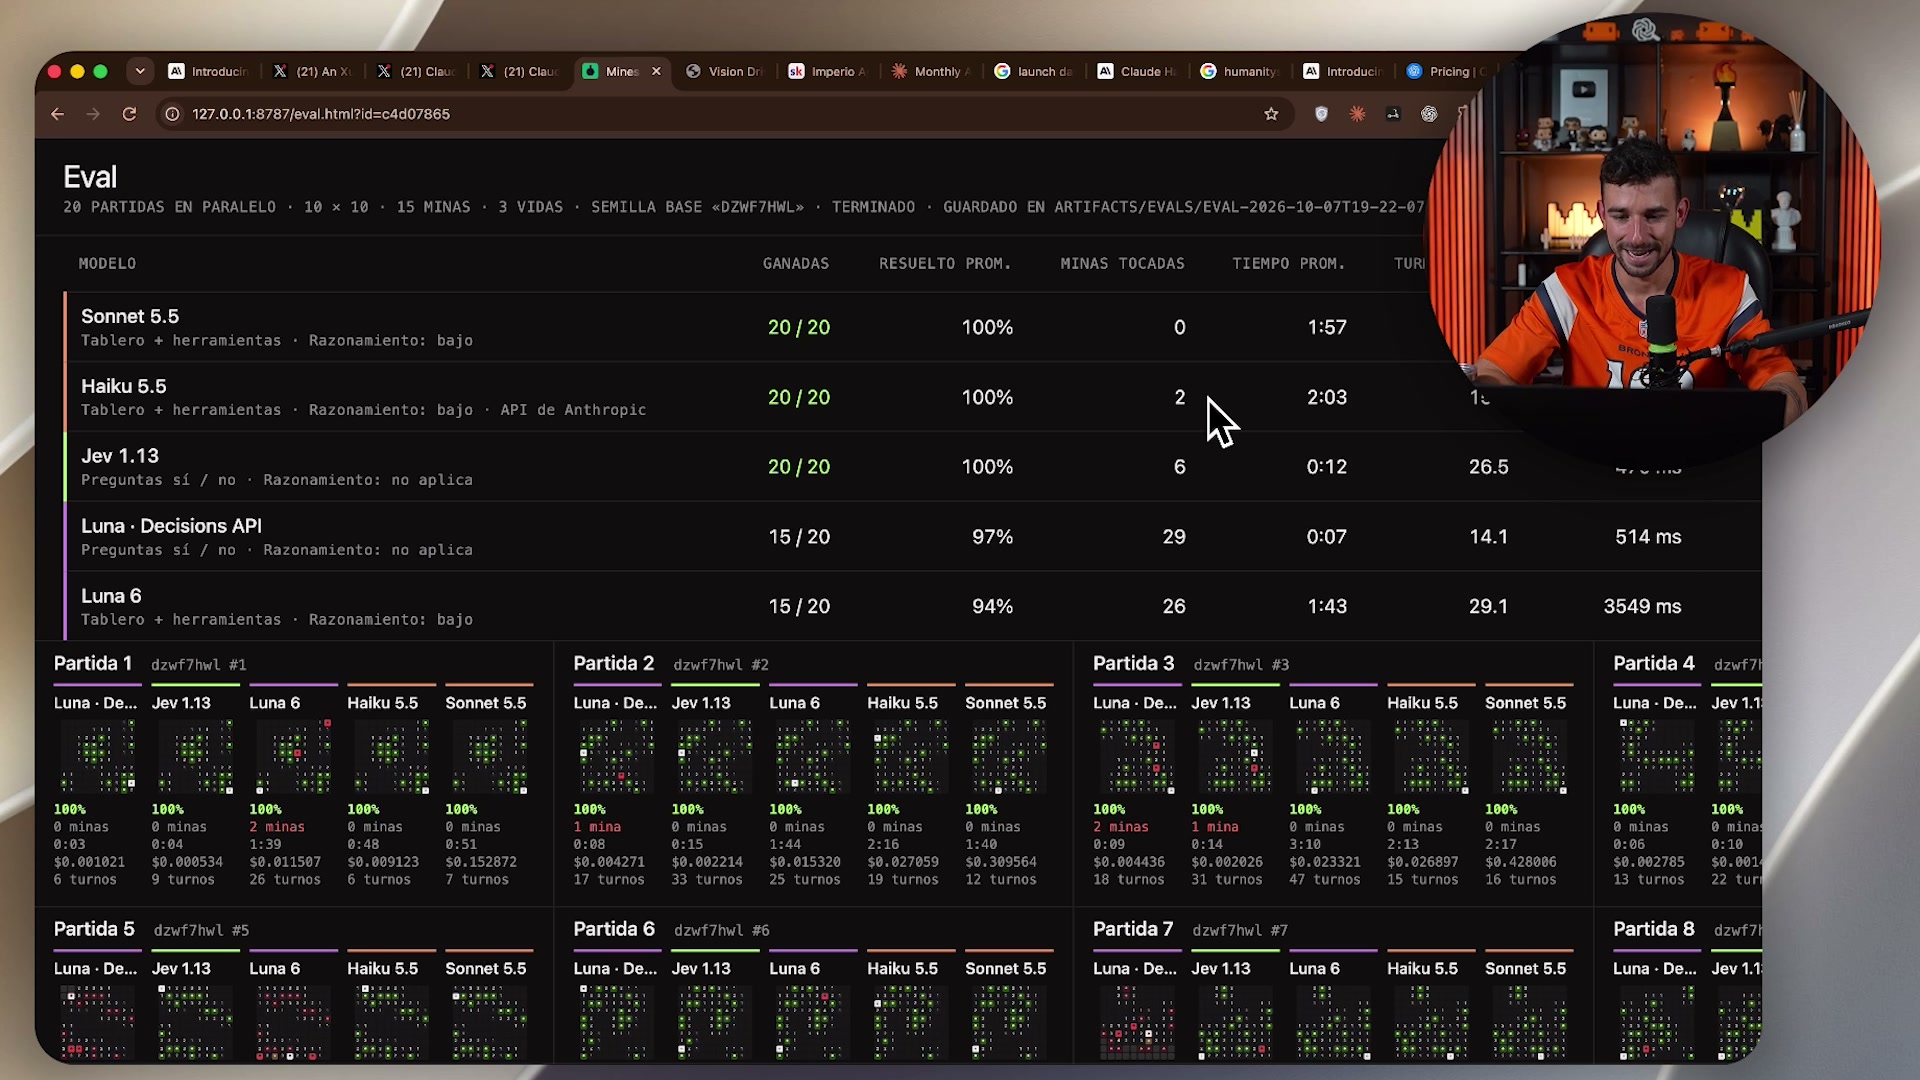
Al narrar redondeo varios importes. Aquí conservo los valores del panel guardado, incluido el de Jev: aproximadamente 3,6 centavos de dólar en total. Eso evita trasladar al artículo una confusión de decimales de la explicación oral.
Qué conclusión saco de esa comparación
Haiku me deja un equilibrio interesante entre costo y acierto. Frente a Luna, tardó 20 segundos más por partida en promedio y costó unos 17 centavos de dólar más en el conjunto. A cambio, tocó muchas menos minas y terminó las 20 partidas.
Sonnet fue el más preciso en esta ejecución. No tocó ninguna mina y terminó en un tiempo parecido al de Haiku. La diferencia grande está en el costo: unos US$7,29 frente a unos US$0,49. Si el error tiene consecuencias importantes, pagar por más precisión puede tener sentido; hay que medirlo en la tarea real.
Jev y Decisions API merecen otra comparación. Resolvieron las decisiones de su formato mucho más rápido, pero son herramientas orientadas a clasificación y no cumplen el mismo papel que un modelo que genera texto y usa herramientas. En el video los incluyo para ver esa diferencia y propongo llevarlos después a casos más específicos.
No usaría 20 partidas de un juego como prueba de superioridad universal. Sí me sirve como primera señal para elegir qué modelos llevar a una evaluación con mis propios casos. Cambiar instrucciones, dificultad, herramientas o nivel de razonamiento puede cambiar el resultado.
Qué miraría antes de ponerlo en un agente
Partiría por una tarea repetitiva y bien delimitada. Guardaría ejemplos fáciles, difíciles y casos donde el modelo suele equivocarse. Después compararía los resultados, la latencia y el costo total de completarlos.
También definiría cuándo escalar a un modelo más capaz. Resumir una conversación corta y decidir cómo resolver un proyecto complejo requieren cosas distintas. El anuncio sitúa a Haiku en ese papel de apoyo, mientras Sonnet y Opus siguen teniendo sentido para trabajo más exigente.
Y revisaría el tamaño real del contexto. Si un agente arrastra toda la conversación a cada paso, la cuenta puede cambiar bastante. Dividir el trabajo sirve solo cuando cada parte conserva la información que necesita; fragmentar por ahorrar tokens puede introducir errores nuevos.
Sonnet baja la caché y llegan créditos de API
El lanzamiento viene acompañado de otras dos novedades. Anthropic reduce a la mitad el precio de las lecturas de caché de Sonnet 5.5, a US$0,10 por millón de tokens. Su estimación es una reducción cercana al 20% en muchos trabajos agénticos, según cuánto se reutilice la caché.
También anuncia créditos mensuales para usar en Claude Platform: US$100 para Max 5x, US$200 para Max 20x y hasta US$500 compartidos para Team. El despliegue se anuncia para esa semana y requiere vincular la suscripción con la plataforma conforme a las condiciones del programa.
Esos créditos sirven para experimentar con aplicaciones y agentes mediante la API. No conviene confundirlos con una ampliación del uso interactivo de Claude Code ni con créditos para consumir Claude desde proveedores externos. Las condiciones están en el centro de ayuda de Claude.
Ya van tres de la familia 5.5. Sigo esperando Fable
Opus, Sonnet y ahora Haiku. Ese ritmo de lanzamientos es parte de lo entretenido del momento. En el cierre del video comento mis ganas de probar Fable 5.5 y la expectativa que hay alrededor.
Por ahora, lo trato como expectativa: las fuentes consultadas para este análisis no confirman una fecha de lanzamiento de Fable 5.5. Los mercados de predicción que muestro reflejan apuestas de sus participantes; no son un calendario oficial de Anthropic.
Mientras tanto, Haiku ya dejó una prueba concreta sobre la mesa. Para mi siguiente evaluación me interesa ver si conserva ese equilibrio al clasificar información, resumir contexto o ejecutar pasos cortos dentro de un agente.
Ver el análisis y la prueba completa
Si quieres aprender a construir agentes y automatizaciones con casos reales, puedes conocer Imperio Agéntico.
Capítulos del video
0:00 Haiku 5.5: el nuevo rival de GPT-6 Luna
1:27 Qué cambia y para qué sirve
5:03 Benchmarks explicados: Haiku vs. Luna y Sonnet
12:31 Precios, caché y contexto largo
16:43 Prueba real: jugando buscaminas
18:49 Evaluación de 20 partidas y resultados
23:30 Qué modelo elegir según la tarea
24:35 Créditos de API para Max y Team
27:13 Fable 5.5 y cierre
Por Benjamín Cordero, creador del canal y cofundador de Imperio Agéntico junto a Maximiliano Cordero.
Preguntas frecuentes
Qué cambia con Claude Haiku 5.5?
Anthropic lo presenta como su nuevo modelo pequeño para tareas frecuentes y sensibles al costo. El anuncio incluye mejoras de rendimiento, razonamiento ajustable y nuevas tarifas. En mi video lo comparo con GPT-6 Luna mediante una evaluación de buscaminas.
Haiku 5.5 fue mejor que GPT-6 Luna en la prueba?
En esta ejecución, Haiku ganó 20 de 20 partidas y tocó dos minas; Luna ganó 15 y tocó 26. Luna fue más rápido y tuvo un costo total menor. El juego permitía tres vidas por partida y los resultados no prueban superioridad universal.
Cuánto cuesta Haiku 5.5 por API?
En el anuncio del 7 de octubre de 2026, hasta 100.000 tokens de entrada cuesta US$0,10 por millón de entrada y US$0,50 por millón de salida. Por encima del umbral, las tarifas son US$0,50 y US$2,50. La caché tiene tarifas propias.
Haiku 5.5 reemplaza a Sonnet u Opus?
El anuncio lo orienta a tareas acotadas y de alto volumen. Para trabajo complejo puede seguir conviniendo un modelo mayor. En mi prueba Sonnet no tocó minas, pero su costo fue considerablemente más alto.
Cuándo llega Fable 5.5?
En el cierre del video comento la expectativa por Fable 5.5. Las fuentes consultadas para este artículo no confirman una fecha de lanzamiento; las apuestas de mercados de predicción no son un anuncio oficial.