
Anthropic lanzó Sonnet 5.5 y ya desarmamos el anuncio entero. El titular llama la atención: muy cerca de Opus 5.5 en varias pruebas, por la mitad del precio en tokens de entrada y salida. Incluso le gana en una de las filas de la tabla.
Pero hay una diferencia entre mirar el precio de un token y saber cuánto te cuesta terminar una tarea. Las lecturas de caché cuestan lo mismo en los dos modelos. Si trabajas con agentes que reutilizan mucho contexto, esa fila merece tanta atención como el resto.
En esta guía recorro lo que analizo en el video del 28 de septiembre de 2026: qué miden los benchmarks, cómo leer el precio y cómo repartiría el trabajo entre Sonnet y Opus. Los resultados de las tablas pertenecen a las evaluaciones del anuncio; este video es un análisis del lanzamiento, no una nueva batería de pruebas propias.
Qué cambia con Sonnet 5.5
Mi primera lectura es que Sonnet se vuelve un candidato muy atractivo para el trabajo cotidiano: corregir un bug con un alcance claro, preparar un documento, armar una presentación o trabajar sobre una planilla cuando sabemos qué resultado queremos.
Opus conserva un lugar para los problemas más abiertos. Si todavía hay que decidir qué construir, investigar por qué falla un sistema o sostener una planificación compleja, el criterio importa tanto como la velocidad de ejecución.
No elegiría un modelo para siempre. Partiría por la tarea que tengo delante. En el video lo planteo así: resolver el plan con Opus y evaluar Sonnet para ejecutar las partes bien definidas.
Los benchmarks, uno por uno
Terminal-Bench: terminar trabajo desde la terminal
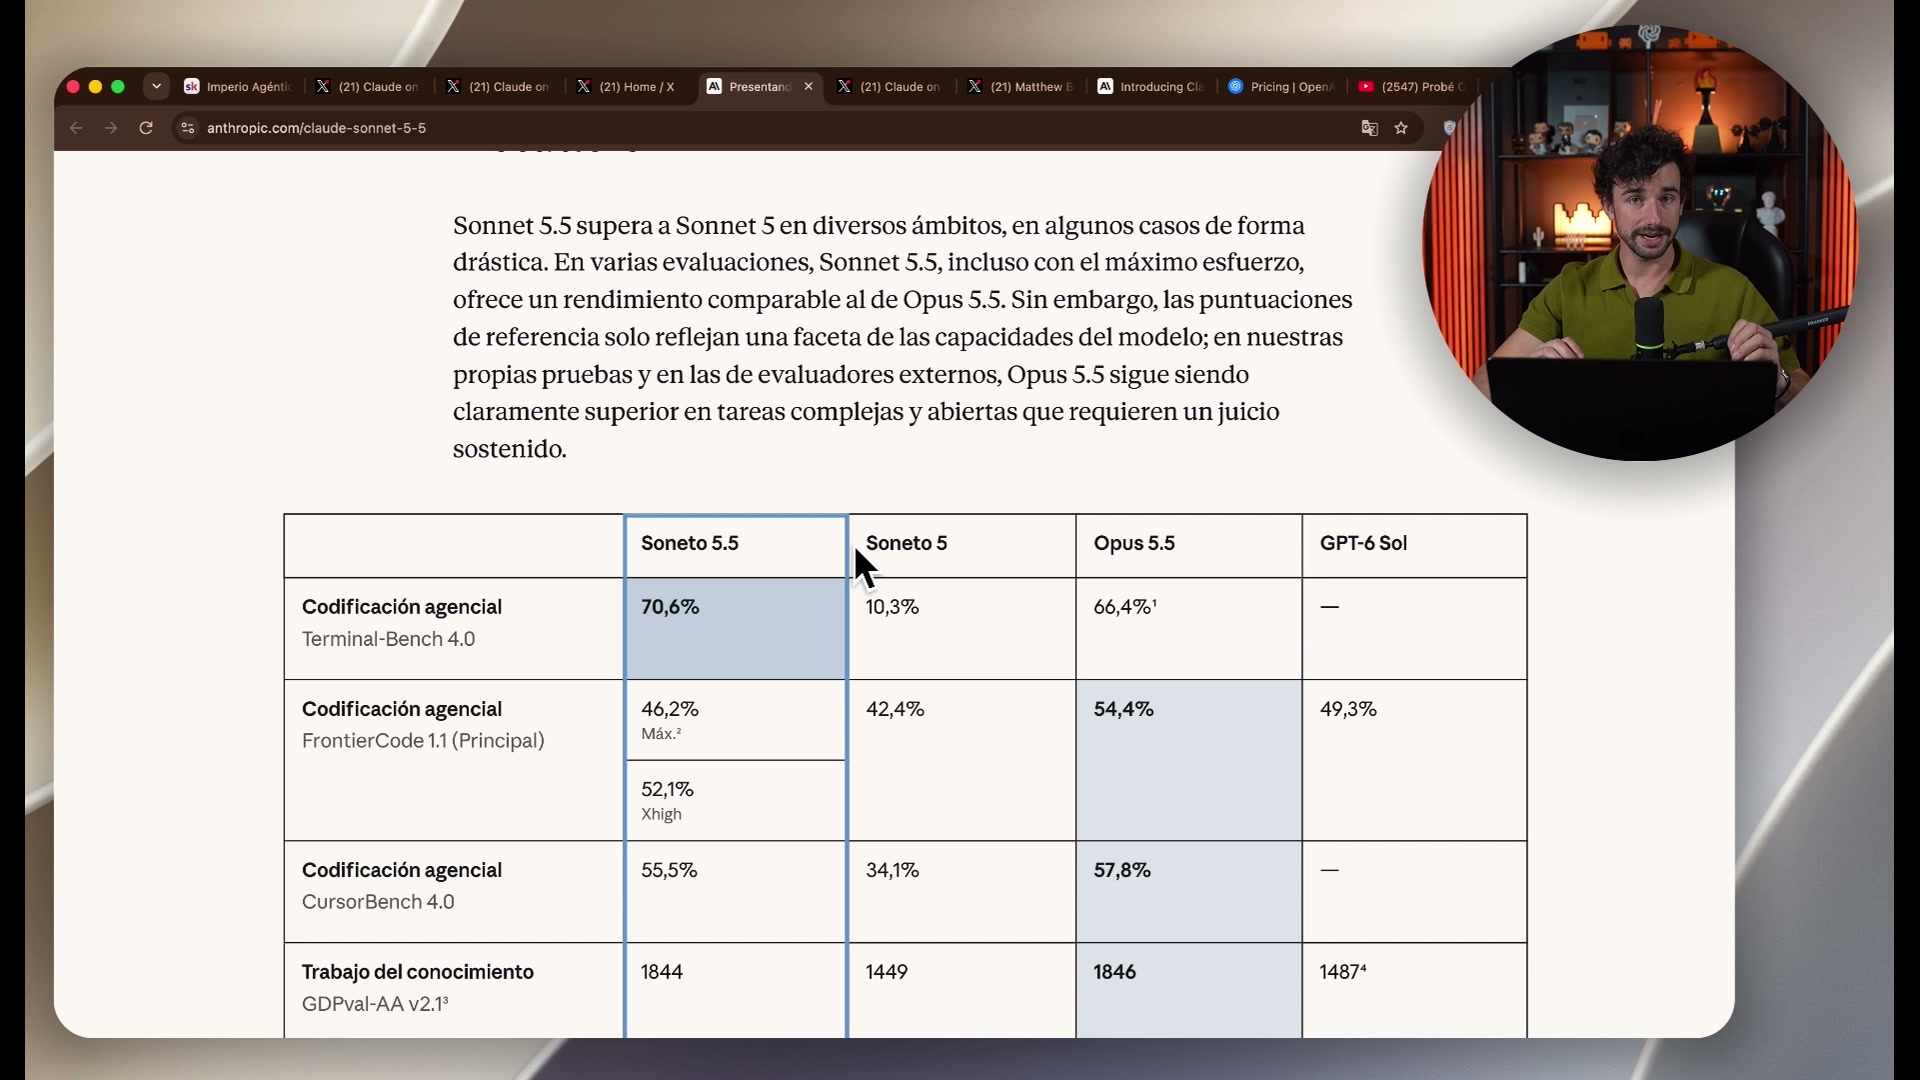
Esta es la fila que más llama la atención. La tabla muestra 70,6% para Sonnet 5.5 y 66,4% para Opus 5.5 en Terminal-Bench 4.0. Son 4,2 puntos porcentuales de diferencia en esa evaluación.
La idea de esta prueba es medir trabajo de varios pasos realizado desde una terminal. Es una forma de interacción muy relevante para agentes de código: leer archivos, ejecutar comandos, comprobar resultados y seguir hasta completar el encargo.
Que Sonnet gane aquí es una señal interesante. No significa que vaya a ganar cualquier tarea de programación, ni que subir varias veces una puntuación vuelva al modelo varias veces más capaz en todo.
FrontierCode: cambios que se puedan aceptar
En el video explico FrontierCode como una evaluación centrada en si el cambio de código se puede aceptar sin que un humano tenga que editarlo. El alcance importa: hacer más cambios de los pedidos puede perjudicar el resultado.
La tabla muestra algo útil para quienes siempre suben el razonamiento al máximo: Sonnet obtiene 52,1% en Xhigh y 46,2% en Max. Opus aparece con 54,4%.
Más esfuerzo no garantiza una entrega mejor. En la explicación del anuncio se mencionan revisiones con subagentes que, en casos examinados, terminaron en un timeout o en modificaciones fuera de alcance. Yo me quedaría con la enseñanza práctica: ajustar el esfuerzo según el trabajo y revisar lo que realmente se entregó.
CursorBench: trabajo dentro del editor
CursorBench se acerca al trabajo de programación en el entorno de Cursor. En la tabla que reviso, Sonnet marca 55,5% y Opus 57,8%.
La posición cambia respecto de Terminal-Bench. Por eso sirve entender qué mide cada fila antes de elegir un ganador general.
GDPval y AA-Briefcase: entregables de trabajo
GDPval-AA evalúa tareas de trabajo intelectual. En el video repaso que abarca 44 ocupaciones y nueve sectores. Sus puntuaciones se presentan como un ranking, no como porcentaje de tareas resueltas.
Sonnet aparece con 1.844 puntos y Opus con 1.846. Están muy cerca en esa medición. En AA-Briefcase, que explico a partir de material de trabajo desordenado y un entregable final, las cifras son 1.811 y 1.822.
Para alguien que quiere usar agentes en documentos, análisis o presentaciones, estas filas aportan contexto distinto al de una prueba de código. La cercanía de las puntuaciones invita a probar Sonnet en ese trabajo; no elimina la revisión del entregable.
Razonamiento, uso del computador y gráficos
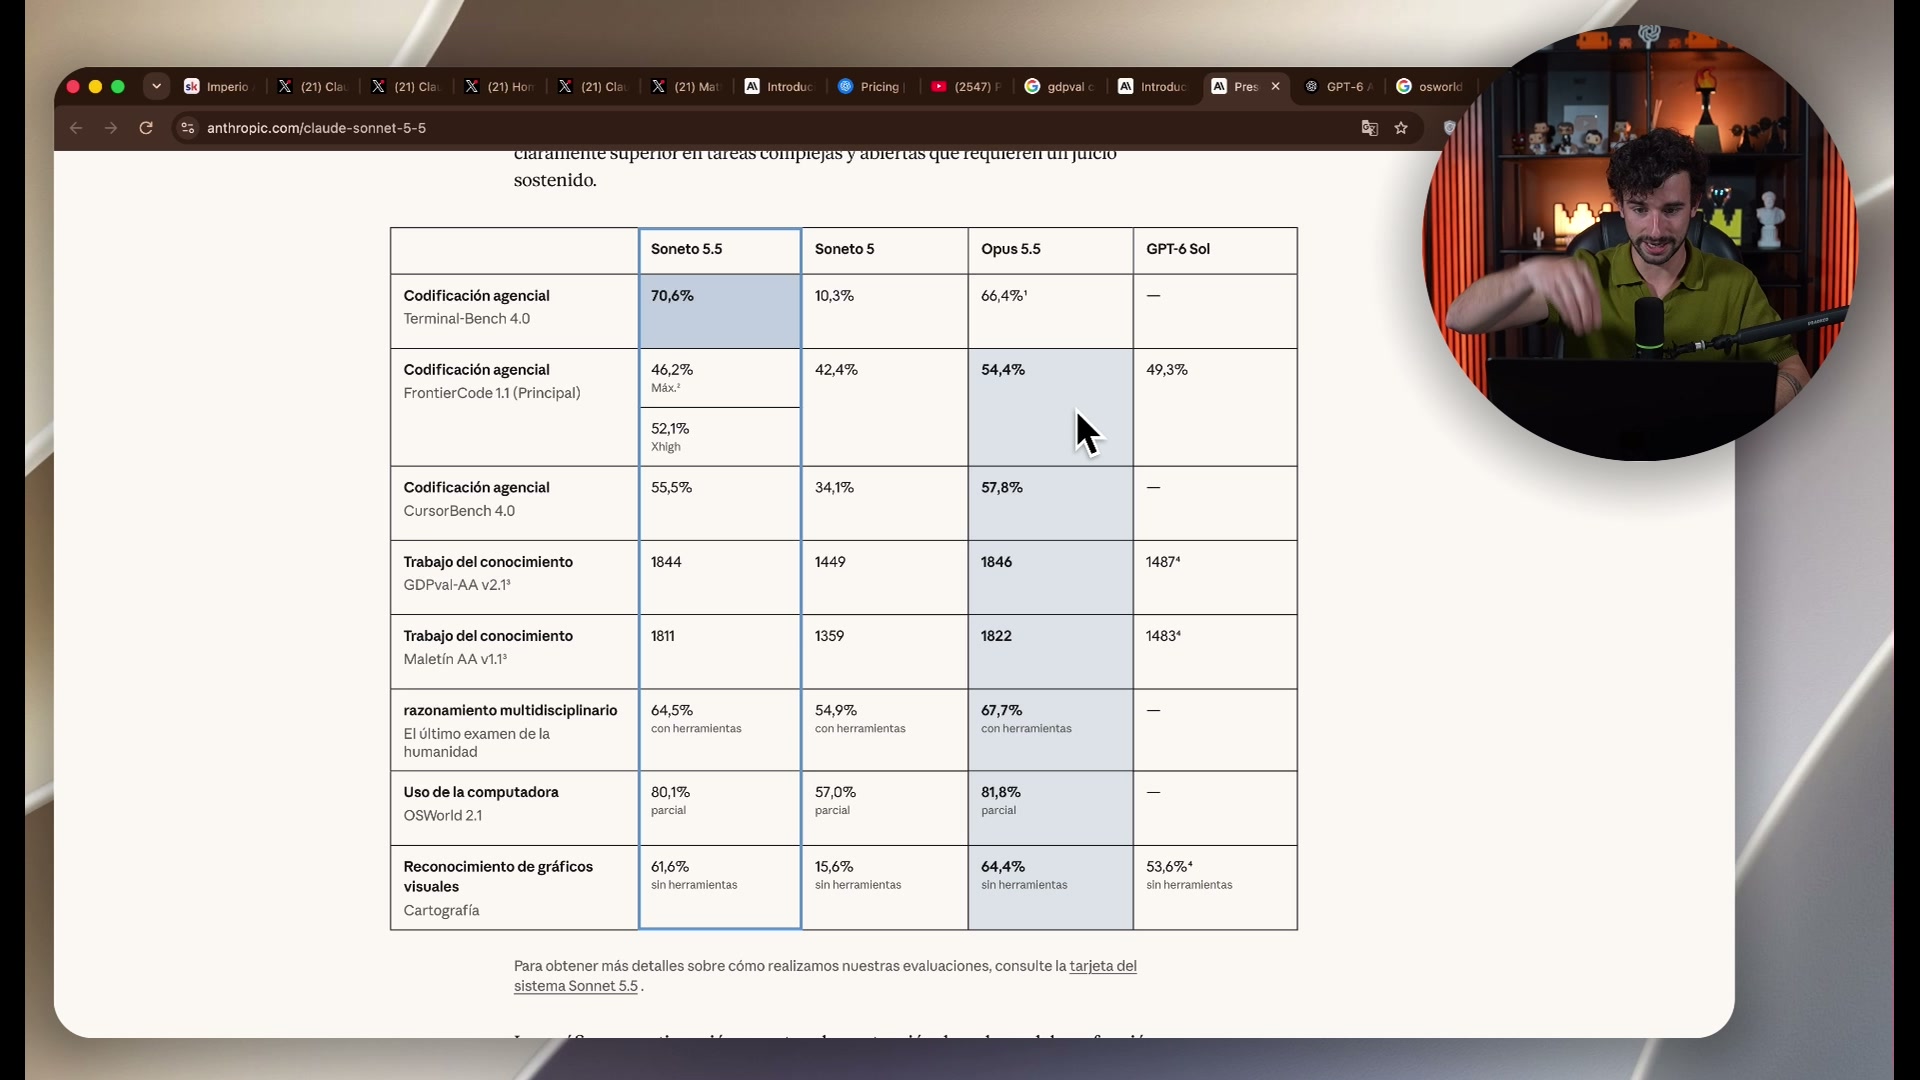
En Humanity’s Last Exam con herramientas, la tabla muestra 64,5% para Sonnet y 67,7% para Opus. En OSWorld 2.1, ambos resultados están etiquetados como parciales: 80,1% y 81,8%. En reconocimiento de gráficos, las cifras son 61,6% y 64,4%.
Son capacidades distintas: responder preguntas difíciles, operar una interfaz y comprender información visual. Yo las miraría en función del trabajo que quiero delegar.
En el video también reviso cifras de GPT-6 Astra. Al comparar publicaciones distintas, conviene conservar el matiz: versión de la evaluación, herramientas y configuración deben coincidir. No usaría OSWorld 2.0 y 2.1 como una comparación perfectamente equivalente sin revisar su metodología.
El precio: la mitad en unas filas, lo mismo en otra
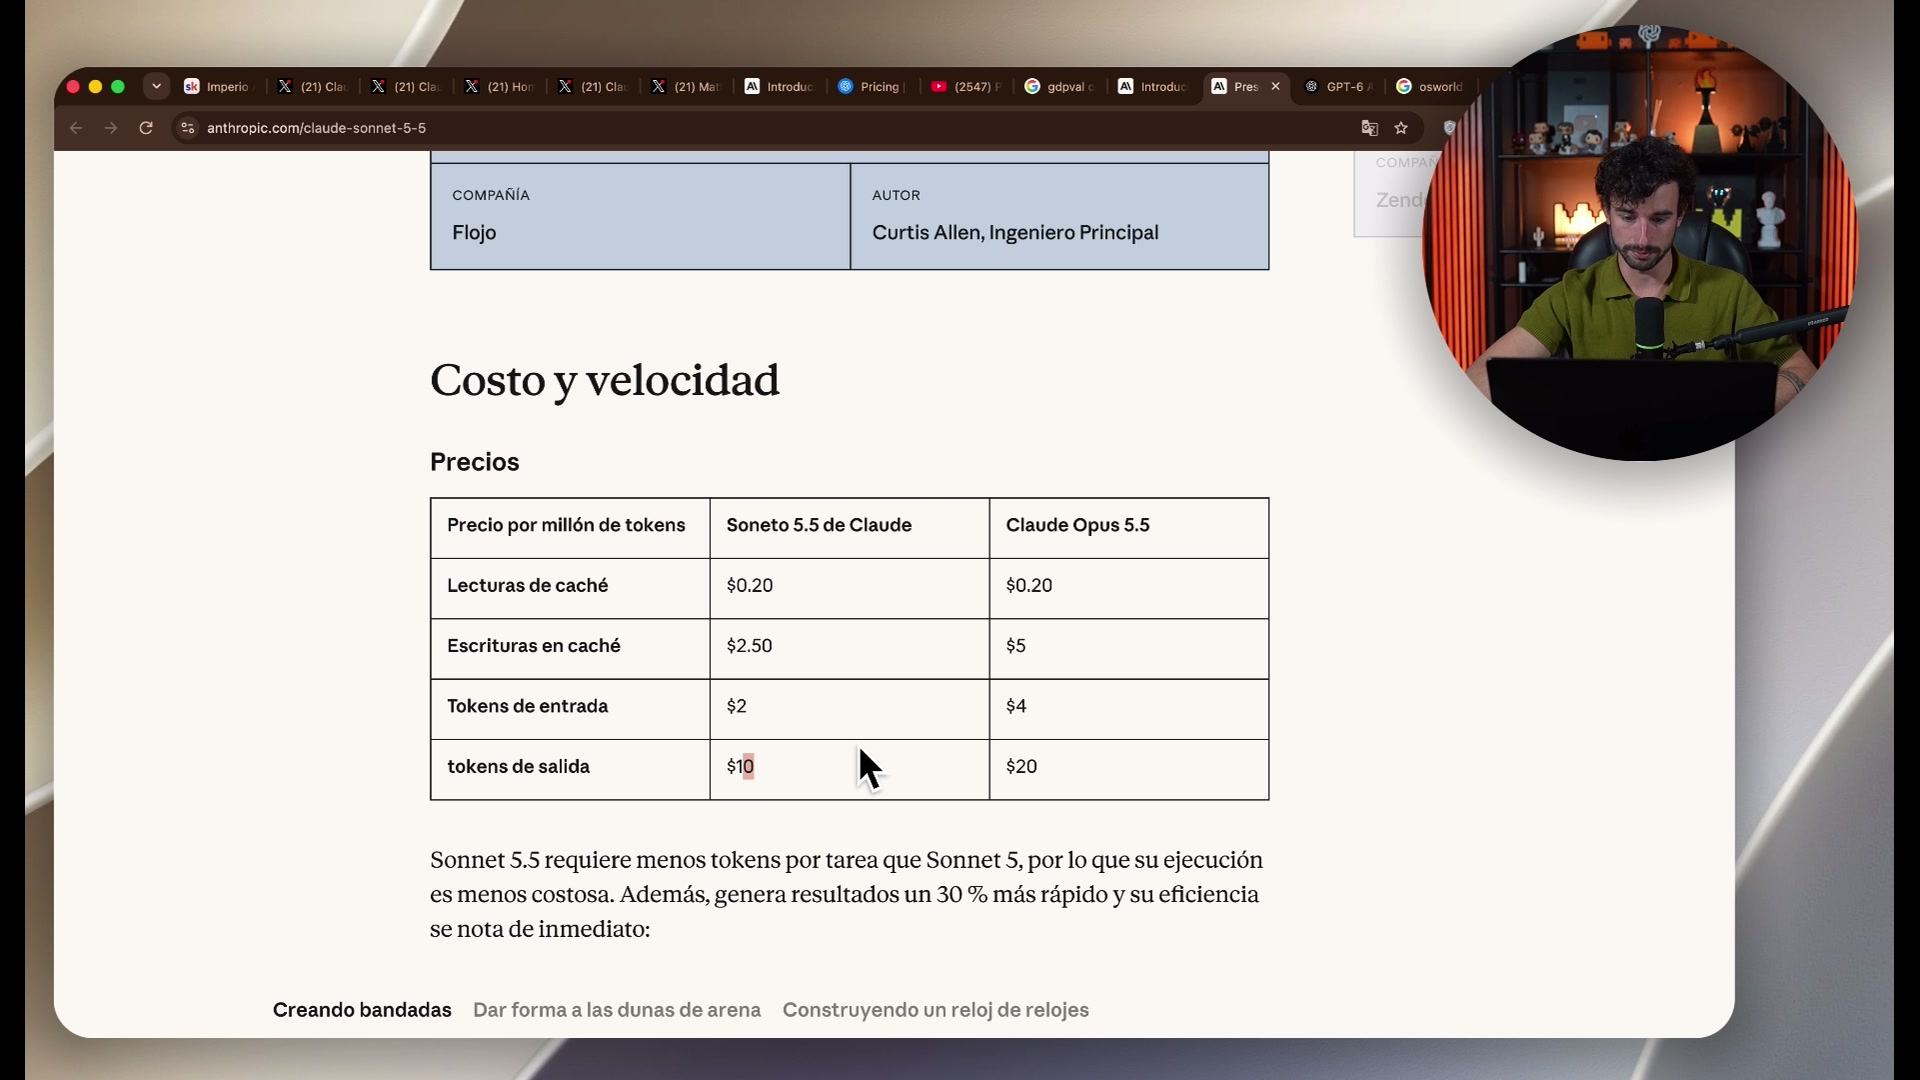
| Concepto | Sonnet 5.5 | Opus 5.5 |
|---|---|---|
| Entrada | US$2 | US$4 |
| Salida | US$10 | US$20 |
| Escrituras de caché, fila del anuncio | US$2,50 | US$5 |
| Lecturas de caché | US$0,20 | US$0,20 |
En entrada y salida, la mitad es la mitad. En lecturas de caché, el ahorro por token es cero.
La caché permite reutilizar contexto. Para la cuenta, hay que distinguir los tokens nuevos de los que efectivamente se leen desde caché. Un agente puede hacer muchas llamadas durante una tarea, y la mezcla entre esas categorías cambia el costo final.
Pensemos en un ejemplo hipotético, manteniendo exactamente el mismo consumo para ambos modelos: 1 millón de tokens de entrada nuevos, 1 millón de salida y 100 millones de lecturas de caché. Sin agregar escrituras de caché, herramientas u otros cargos, Sonnet costaría US$32 y Opus US$44. El ahorro sería de aproximadamente 27,3%, no de 50%.
Ese ejemplo no es una factura mía ni un rendimiento medido. Solo muestra por qué no basta con mirar dos filas de la tabla. En un trabajo real también cambian la cantidad de tokens, los reintentos y el tiempo que dedicas a corregir el resultado.
Aclaración sobre el 30%: el anuncio presenta Sonnet 5.5 como hasta un 30% más económico para la mayoría del trabajo frente a Sonnet 5. No es una promesa de ahorro fijo del 30% frente a Opus 5.5. Para esa comparación hay que medir el consumo de tu flujo. Anuncio oficial de Sonnet 5.5.
API y suscripción son cuentas diferentes
Los precios anteriores corresponden a API. Si pagas una suscripción, no puedes convertir automáticamente una rebaja por token en el doble de mensajes disponibles.
En ese caso te interesa cómo rinde el modelo dentro de tus límites y qué tanto trabajo útil alcanzas a completar. En API, además, puedes comparar consumo y costo por tarea de forma directa.
Para elegir, registraría tres cosas en algunos trabajos representativos: si el resultado quedó bien, cuánto costó y cuánto demoró. Si la salida más barata necesita muchas correcciones, eso también forma parte de la decisión.
Cómo empezaría a usarlo en Claude Code
La documentación oficial permite cambiar el modelo con /model. Para seleccionar la versión concreta desde la API de Anthropic, el identificador es claude-sonnet-5-5. Los alias y la disponibilidad pueden depender del proveedor y de la versión instalada. Configuración de modelos en Claude Code.
Mi punto de partida sería este:
- Elegir una tarea habitual con un resultado fácil de evaluar.
- Probar Sonnet con instrucciones y alcance claros.
- Revisar el resultado antes de subir el esfuerzo por costumbre.
- Reservar Opus para el trabajo más abierto o para los casos en que Sonnet no resuelva bien.
- Comparar costo y calidad sobre el mismo tipo de encargo.
No es necesario migrar todos tus agentes de una vez. Basta con identificar dónde Sonnet te entrega la calidad que necesitas y medirlo ahí.
Y qué pasa con Fable 5.5?
Que Anthropic presente a Sonnet como el segundo modelo de la familia me deja atento a lo que venga después. En el video comparto mi expectativa sobre Fable 5.5, pero es una teoría.
La comunicación de Opus 5.5 sí mencionó Sonnet y Haiku como próximos miembros. Eso no confirma una fecha de Fable ni la retirada de Haiku. Mantendría separada la expectativa del lanzamiento que ya podemos analizar. Anuncio de Opus 5.5.
Lo interesante hoy es Sonnet: un modelo que merece una prueba en tareas cotidianas, con una tabla de resultados fuerte y un precio que hay que leer completo.
Video completo y capítulos
- 00:00 Sonnet 5.5: Opus a mitad de precio
- 00:54 Se viene Fable 5.5?
- 02:47 Cuándo usar Sonnet y cuándo Opus
- 04:11 Los benchmarks, uno por uno
- 14:32 Resumen de la tabla
- 16:21 Cómo lo usaría yo
- 17:00 Precios: la parte donde cuestan lo mismo
- 19:33 API vs suscripción
- 21:29 Cómo usarlo en Claude Code
- 22:13 Imperio Agéntico
Si quieres seguir con una comparación de trabajos concretos, puedes leer Opus 5.5 vs GPT-6 Astra en 12 trabajos reales. Para aprender el entorno, empieza por la biblioteca de Claude Code.
Soy Benjamín Cordero, creador del canal y cofundador de Imperio Agéntico junto a Maximiliano Cordero. En la comunidad construimos agentes y compartimos implementaciones.
Preguntas frecuentes
Sonnet 5.5 cuesta la mitad que Opus 5.5?
La entrada y la salida cuestan la mitad por millón de tokens, pero las lecturas de caché cuestan US$0,20 en ambos. El ahorro por tarea depende del consumo y los reintentos.
En qué benchmark supera Sonnet 5.5 a Opus 5.5?
En la tabla analizada, Terminal-Bench 4.0 muestra 70,6% para Sonnet y 66,4% para Opus. No implica que gane en todas las tareas de programación.
Cuándo usaría Sonnet y cuándo Opus?
Partiría con Sonnet en tareas cotidianas bien definidas y reservaría Opus para planificación o problemas abiertos. Después mediría calidad, costo y tiempo en el flujo real.
El ahorro del 30% es frente a Opus?
El anuncio compara Sonnet 5.5 con Sonnet 5. No promete un ahorro fijo del 30% frente a Opus 5.5.
Está confirmado Fable 5.5?
La expectativa sobre Fable 5.5 presentada en el video es una teoría. No se ofrece una fecha confirmada de lanzamiento.