
Le pedí un juego de naves a Claude Fable 5.2, Opus 5.5 y GPT-6 Astra. El mismo prompt, letra por letra. Opus estuvo 109 minutos. Fable, 28. Astra, 19.
Después abrí los tres juegos y me puse a jugar. Porque terminar antes importa, pero también importa qué te entrega el modelo.
Esa fue una de las tres pruebas que hice para este lanzamiento. También les pedí un comercial con IA y un juego en 3D. Mi primera conclusión es que seguiría usando Opus para el día a día y probaría Fable en trabajos más exigentes. Los resultados ayudan a entender por qué.
Primero, cómo hice la comparación
Fable y Opus trabajaron en Claude Code. Astra, en Codex. Recibieron el mismo encargo en cada prueba y no fui ayudando a uno para que alcanzara al otro.
Hay dos condiciones que cambian la lectura:
- Hice una sola corrida por modelo y por prueba.
- Fable no estaba en su esfuerzo máximo. Quería tener los resultados a tiempo para grabar el video.
No es una evaluación controlada de fiabilidad ni una comparación de todos los modelos con el esfuerzo igualado. Son primeras pruebas del trabajo que entregaron en esas condiciones.
Los montos que muestro son costos calculados a precio de API a partir de los registros, no facturas pagadas. Tampoco representan necesariamente el costo completo de los servicios externos usados para crear los comerciales.
El juego de naves: 28 minutos frente a 109
Aquí apareció la diferencia de tiempo más grande frente a Opus.
| Modelo | Tiempo registrado | Costo calculado a precio de API |
|---|---|---|
| Fable 5.2 | 28 minutos | US$15,97 |
| Opus 5.5 | 109 minutos | US$30,65 |
| GPT-6 Astra | 19 minutos | US$4,07 |
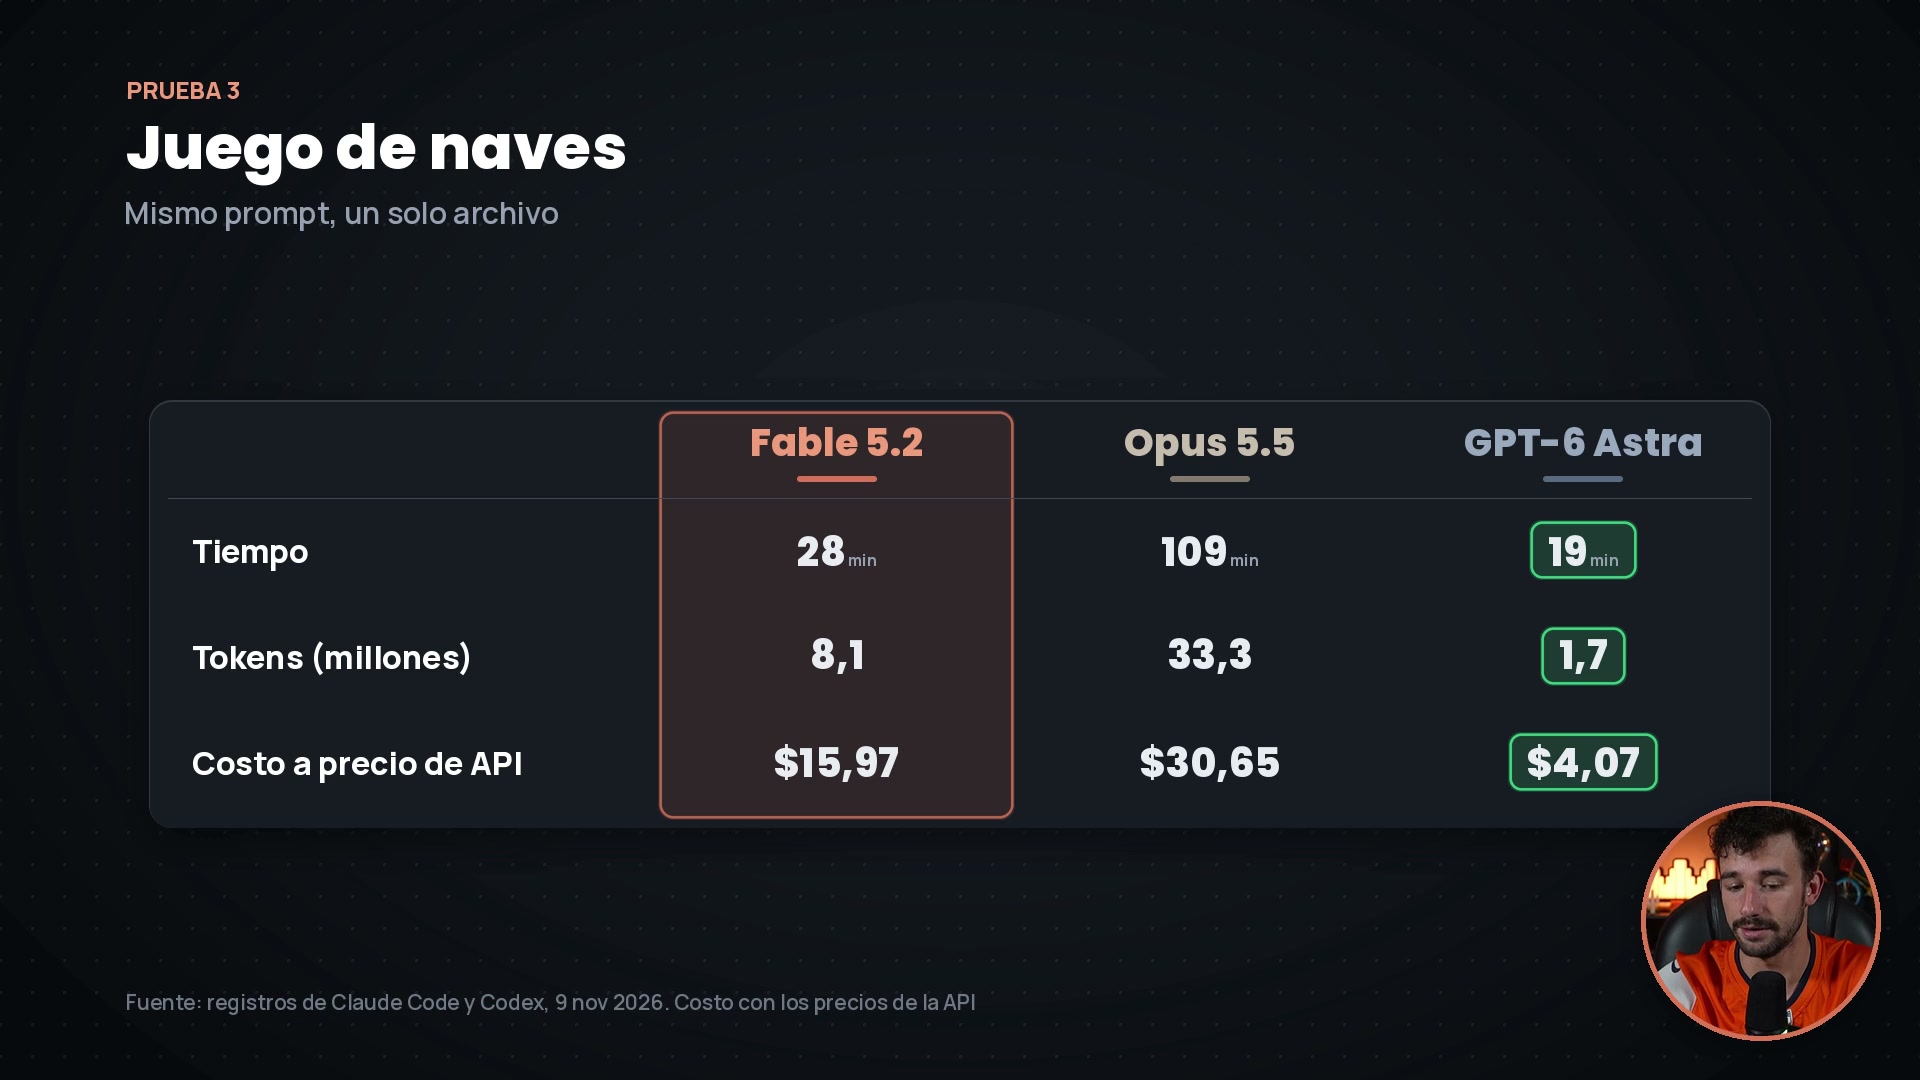
El juego de Opus funcionaba bien: podía moverme, perder vida, mejorar el arma y volver al menú. El de Astra también era jugable. Lo sentí algo más lento en las animaciones, aunque había terminado de construirlo antes que los demás.
El de Fable, Órbita Cero, se sentía más suave y me gustaron algunas mejoras de las armas. Tampoco vi una distancia enorme frente al de Opus.
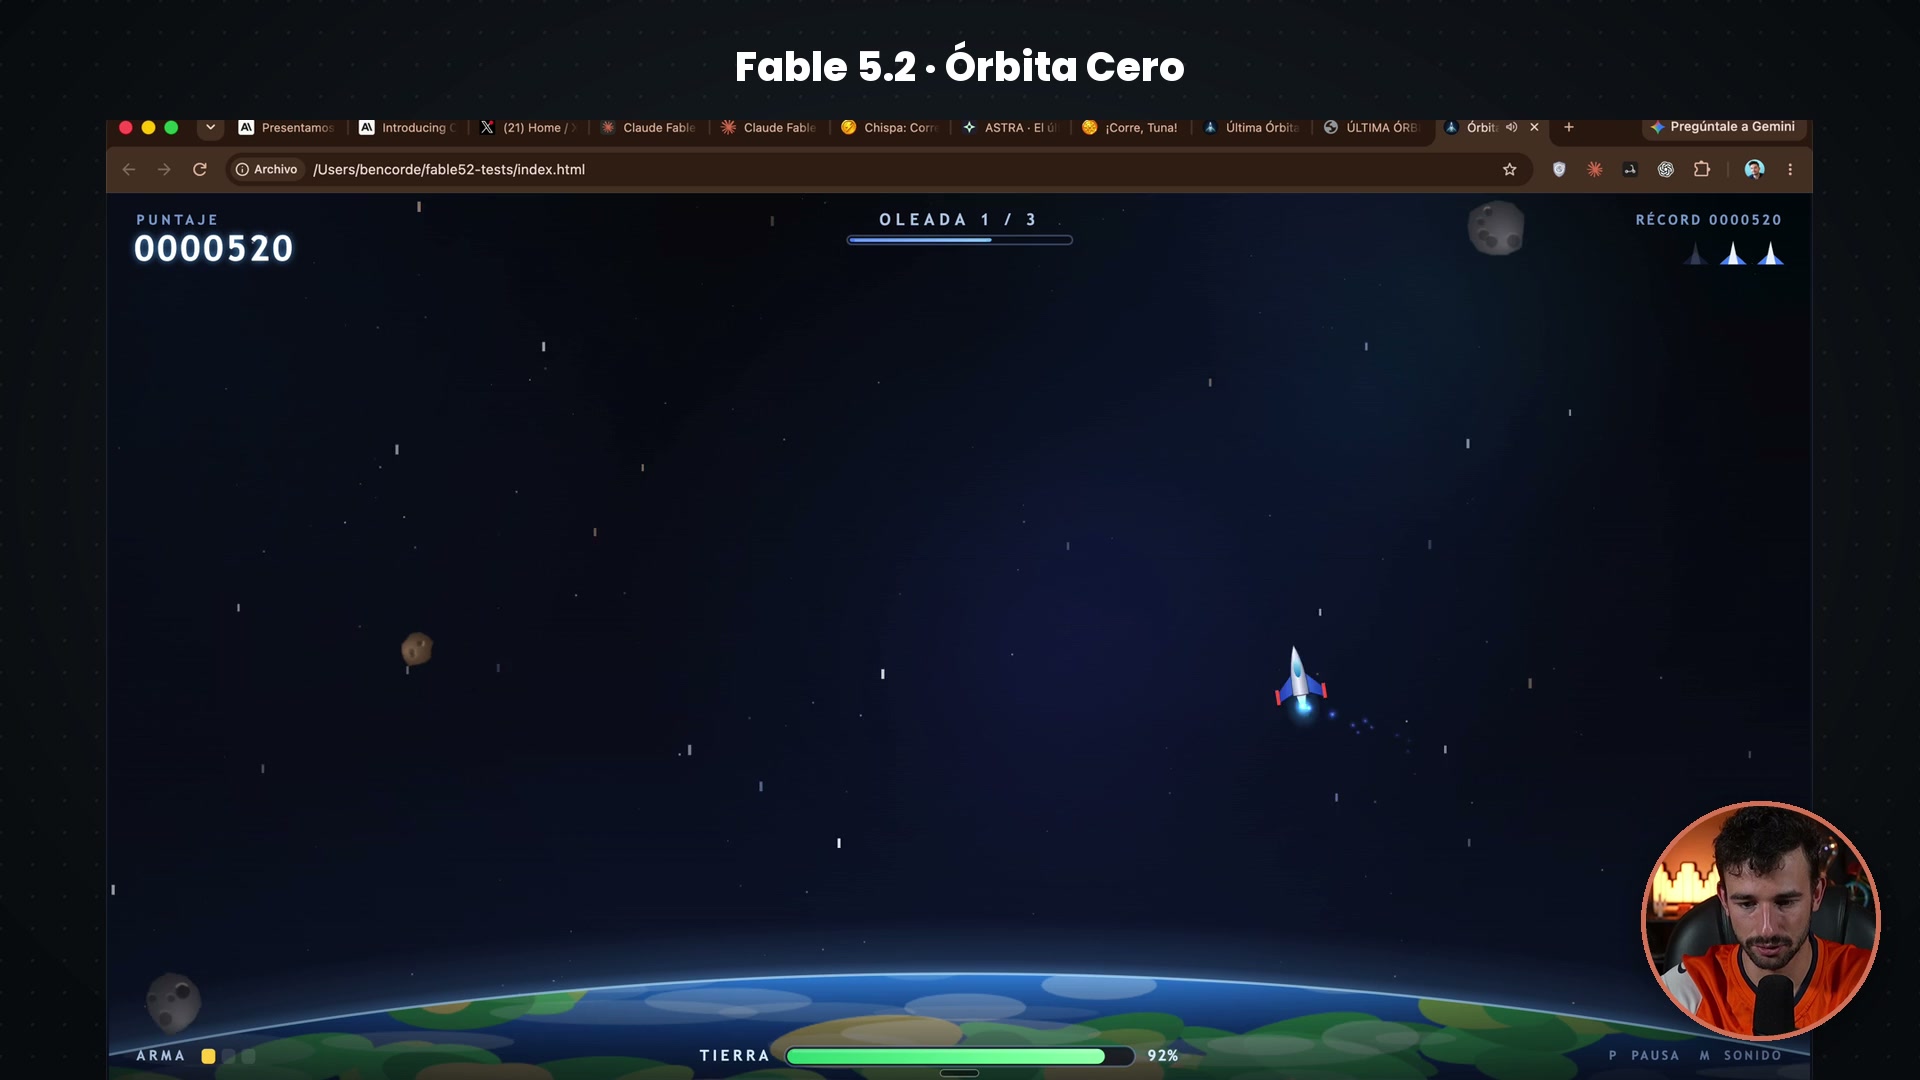
Eso es lo útil de verlos funcionando. La tabla te dice cuánto demoraron y cuánto costaría ese consumo. Jugar te muestra controles, respuesta, animaciones y detalles que no aparecen en esos números.
En el juego 3D, Fable salió más caro
En esta prueba, Opus entregó un juego que me gustó. Probé las colisiones, el regreso al menú y cómo se adaptaba al celular.
Con Astra me pasó algo muy concreto: no pude saltar ni agacharme durante la prueba. La portada se veía bien, pero esos controles cambiaban la experiencia al jugar.
Con Fable pude saltar y bajar. El resultado funcionaba, aunque el acabado gráfico no me convenció en todo.
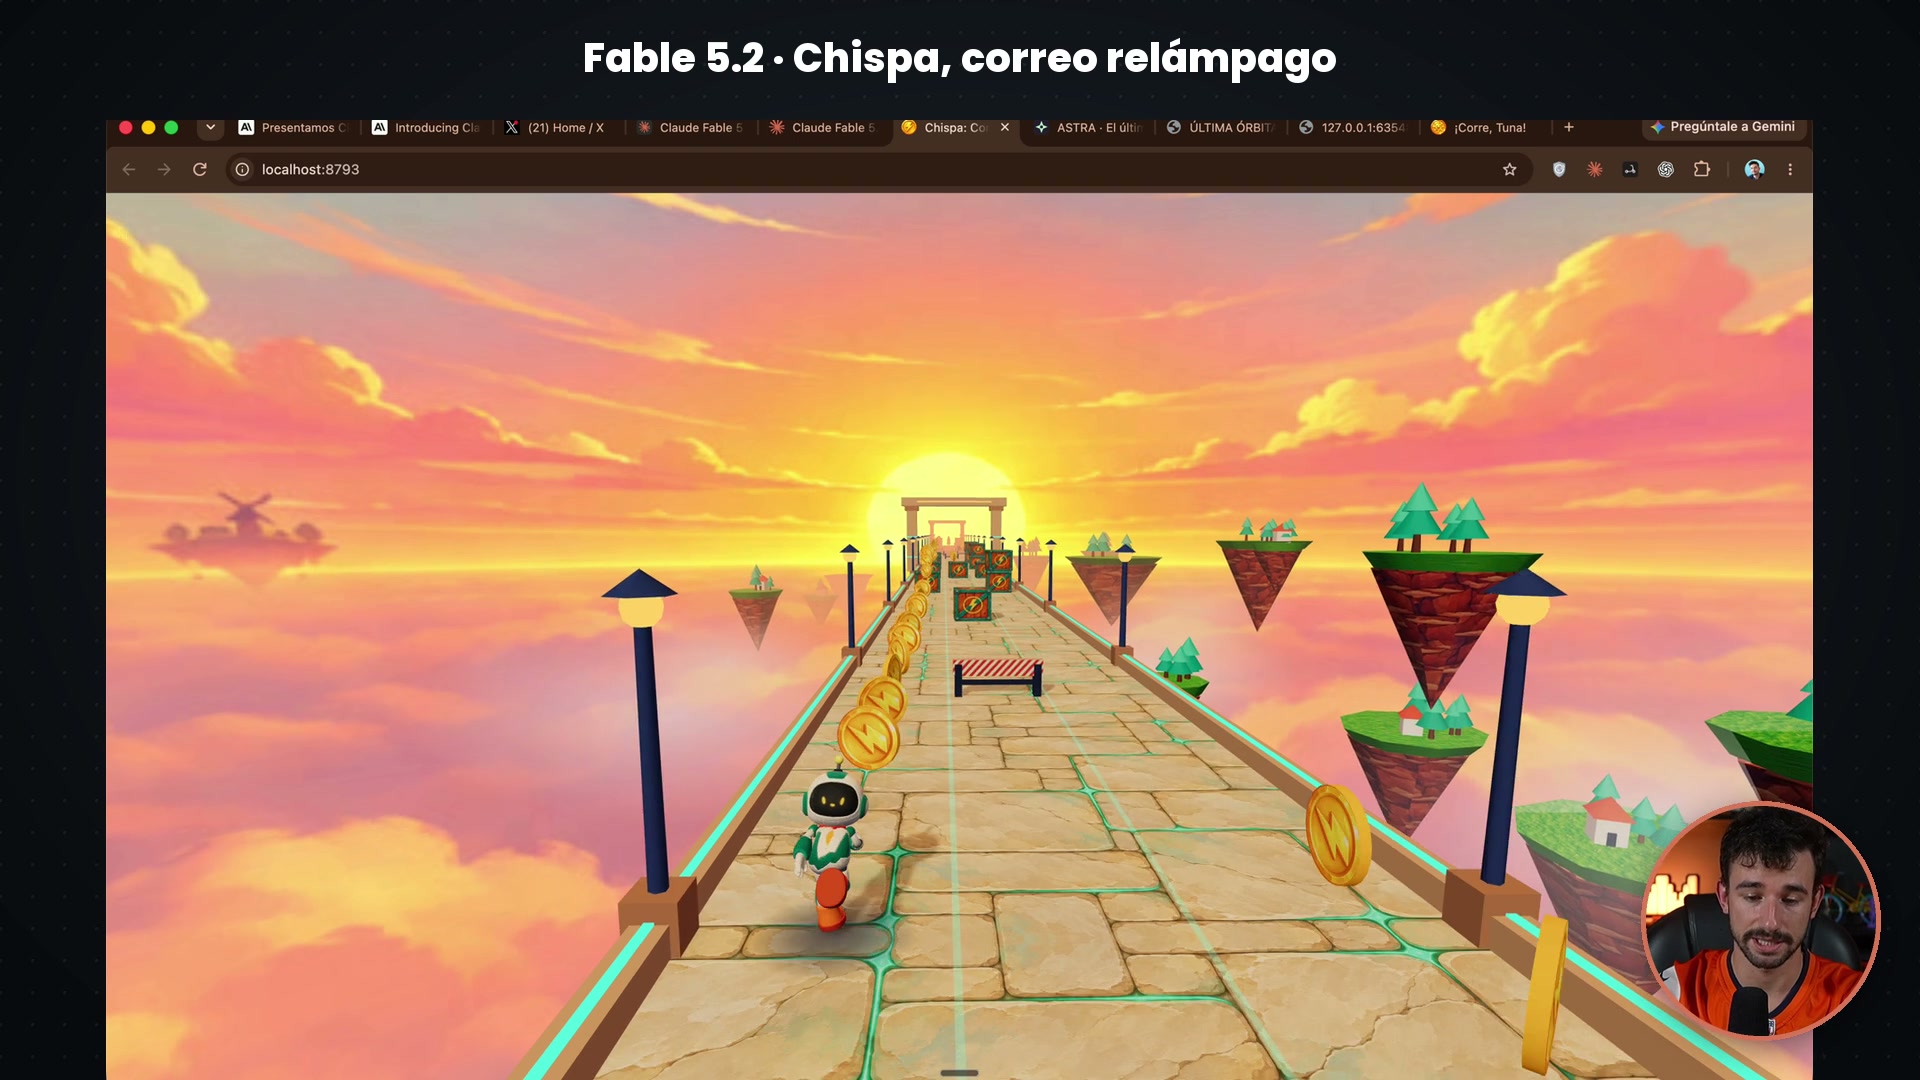
En la tabla mostrada en el video, los costos calculados fueron US$33,91 para Fable, US$28,51 para Opus y US$9,99 para Astra.
Por eso no diría que mis pruebas demuestran que Fable siempre sale más barato. En el juego de naves costó menos que Opus. En el 3D, más. Y el precio más bajo de Astra no resolvió por sí solo los problemas que encontré al jugar.
El comercial: también hubo fallas
Para el comercial, los agentes usaron Higgsfield para generar el material. Aquí hubo movimientos extraños, una voz que no me gustó y un pie que apareció al revés.
Algunos efectos de Fable se veían mejor, pero también encontré una transición rara. Mi impresión al grabar fue que esa prueba no daba una comparación especialmente clara.
No la usaría para proclamar un ganador. Sí sirve para ver lo que tienes que revisar cuando le encargas un comercial completo a un agente: continuidad, movimiento, voz, montaje y resultado final.
Cuánto cuesta Fable 5.2 y qué cambia frente a Opus
Anthropic publicó Fable 5.2 y Mythos 5.2 el 9 de noviembre de 2026. Comparten el modelo base. Fable añade salvaguardas de ciberseguridad y biología, mientras que el acceso a Mythos requiere verificación.
El precio estándar anunciado para Fable es US$8 por millón de tokens de entrada y US$40 por millón de salida. Es un 20% menos que Fable 5.1. Frente a los US$4 y US$20 de Opus 5.5 que comparo en el video, sigue siendo el doble por token.
El anuncio también muestra que Fable puede alcanzar resultados parecidos a Opus con menos consumo en determinadas evaluaciones. Eso permite un menor costo por tarea aunque cada token sea más caro. Es una comparación de Anthropic, no una garantía para cualquier encargo. Anuncio oficial.
Mi juego de naves ilustra esa posibilidad. El juego 3D muestra por qué conviene medirla en tu propio trabajo.
Qué dice la tabla oficial
Fable destaca en la tabla que reviso, pero hay matices. En AutomationBench, Gemini 4 Carbon obtiene 53,9% y Fable 51,4%. En AA-Briefcase, Fable gana por rúbrica y Opus queda por delante en Elo.
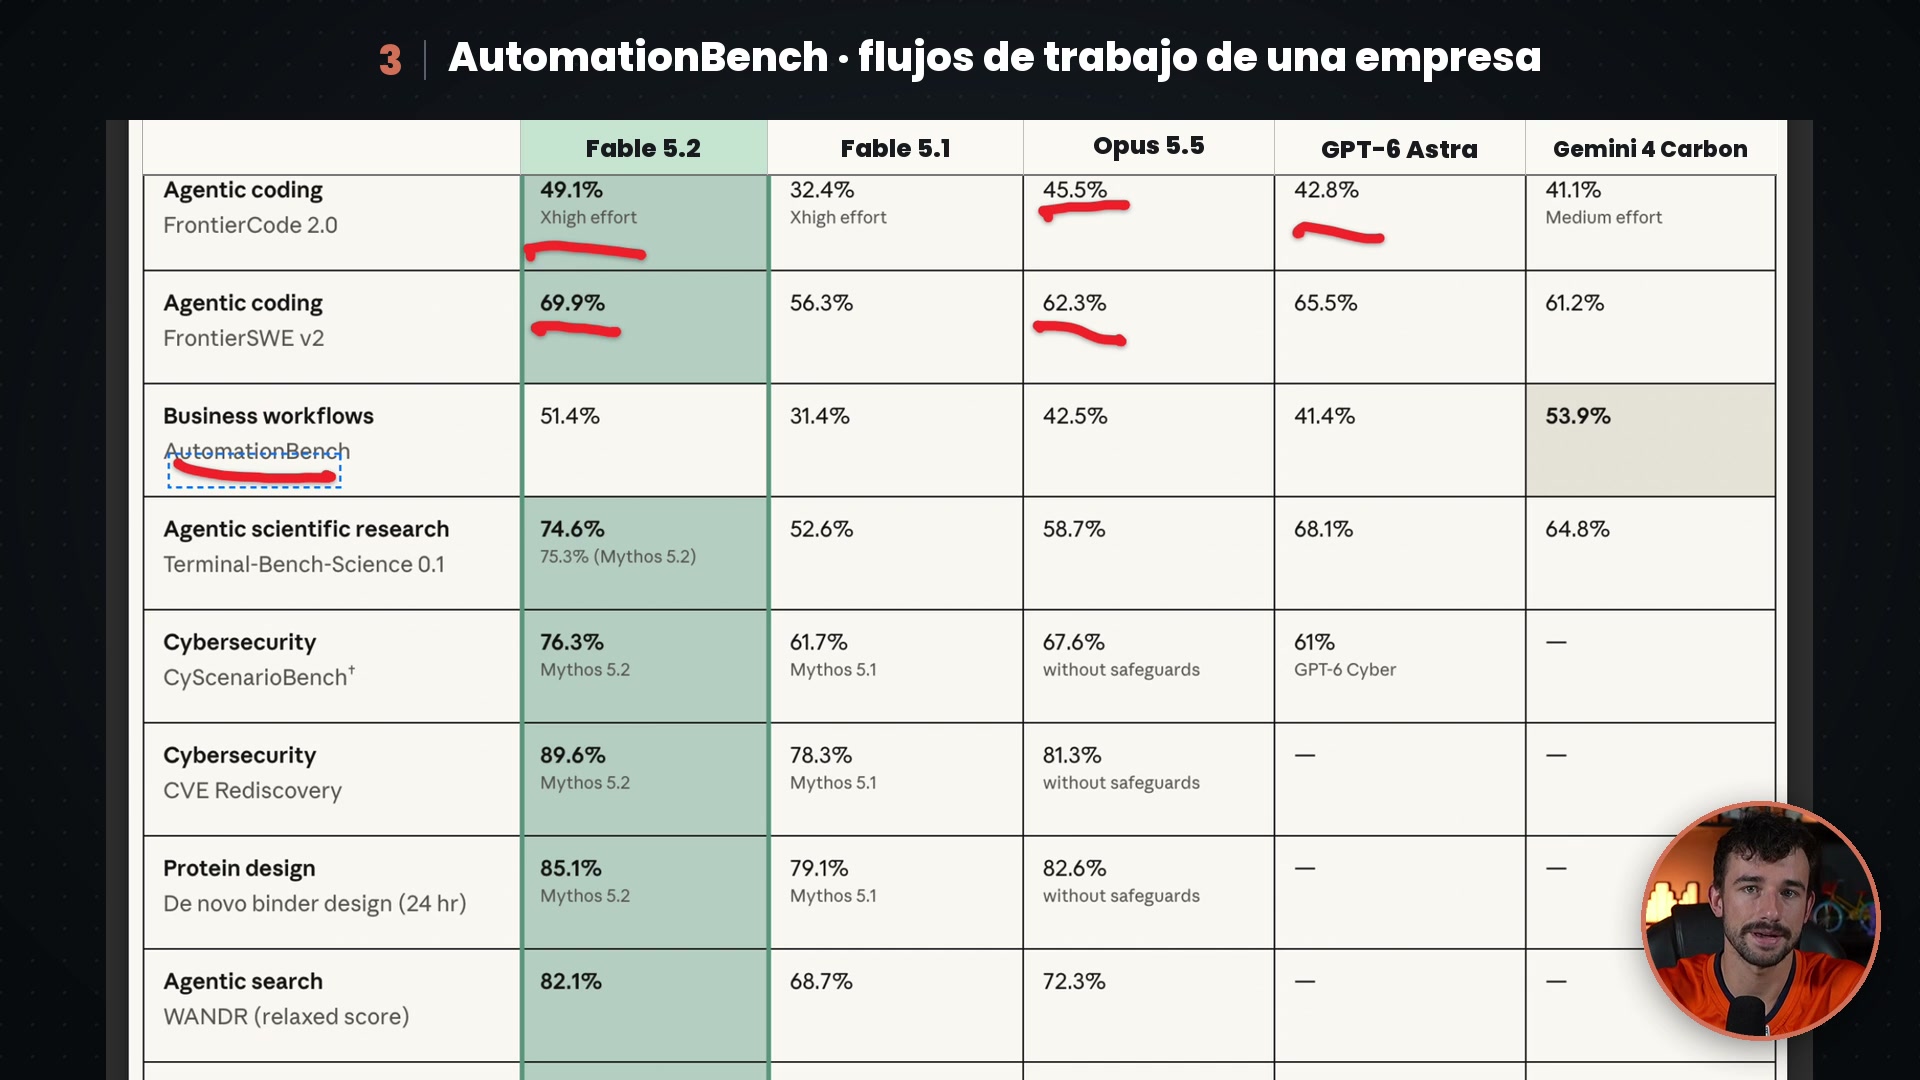
Son evaluaciones publicadas por el fabricante, con sus condiciones de esfuerzo y metodología. No las mezclaría con mis tres ejecuciones como si fueran el mismo tipo de evidencia. Metodología y resultados.
Cuándo seguiría con Opus y cuándo probaría Fable
Para el trabajo habitual, seguiría con Opus 5.5. Fable me interesa para proyectos largos, diagnósticos difíciles o encargos donde Opus ya no está resolviendo bien.
Antes de cambiar el modelo de todo tu sistema, tomaría una tarea que conozcas y compararía cuatro cosas:
- Si terminó lo que le pediste.
- Si el resultado funciona cuando lo usas.
- Cuánto tiempo y consumo necesitó.
- Cuánto tuviste que corregir después.
Si el primer resultado promete, repetiría la prueba. Una sola ejecución ayuda a encontrar algo que vale la pena explorar. Varias permiten empezar a distinguir una mejora consistente de una buena corrida.
Tengo ganas de probar Fable con búsquedas entre archivos, RAG y trabajos más largos. Este video deja a la vista la primera ronda, con lo que funcionó y lo que todavía no me convence.
Si quieres aprender a construir y probar estos sistemas, dentro de Imperio Agéntico compartimos implementaciones, cursos y trabajo de la comunidad.
Video completo y capítulos
Puedes ver los resultados en movimiento y la explicación completa en el video.
- 0:00 Fable 5.2 contra Opus 5.5 y GPT-6 Astra
- 1:25 Qué es Fable y qué es Mythos
- 2:29 Los benchmarks, uno por uno
- 3:56 Dónde pierde: AutomationBench
- 11:48 El precio y el costo por tarea
- 12:56 Planes y promoción de lanzamiento
- 13:28 Cómo hice las tres pruebas
- 13:44 El comercial
- 15:24 El juego en 3D
- 17:08 El juego de naves
- 19:05 Tiempo y costo
- 20:07 Evaluaciones y límites del anuncio
- 21:39 Mi veredicto
- 23:13 Cierre
Las condiciones de acceso y promociones pueden cambiar. Para revisarlas, consulta la oferta de lanzamiento de Anthropic.
Benjamín Cordero, creador de @bencord y cofundador de Imperio Agéntico junto a Maximiliano Cordero.
Preguntas frecuentes
Fable 5.2 es más barato que Opus 5.5?
Por token, el precio estándar de Fable 5.2 comparado en el video es el doble. El costo de una tarea depende también del consumo. En mi juego de naves, Fable tuvo menor costo calculado a precio de API que Opus. En el juego 3D salió más caro.
Estas pruebas usaron el máximo esfuerzo en Fable?
No. Fable se ejecutó con menos esfuerzo que el máximo y solo hice una corrida por modelo en cada encargo. Son primeras pruebas con esas condiciones, no una evaluación controlada de fiabilidad.
Qué modelo usaría para el día a día?
Mi primera conclusión es seguir con Opus 5.5 para el trabajo habitual y probar Fable 5.2 en tareas largas, complejas o que Opus no esté resolviendo bien. Antes de cambiar un flujo completo, repetiría las pruebas con el trabajo real.